2026 年最適合寫作的 Claude:最新的 Opus 暫時領先,差距還沒站穩
Opus 5.5 在創意寫作榜上分數最高,但相對 Fable 5 和 Opus 4.6 的領先還沒站穩。起草、改稿、日常寫作各自該怎麼選,以及價格。
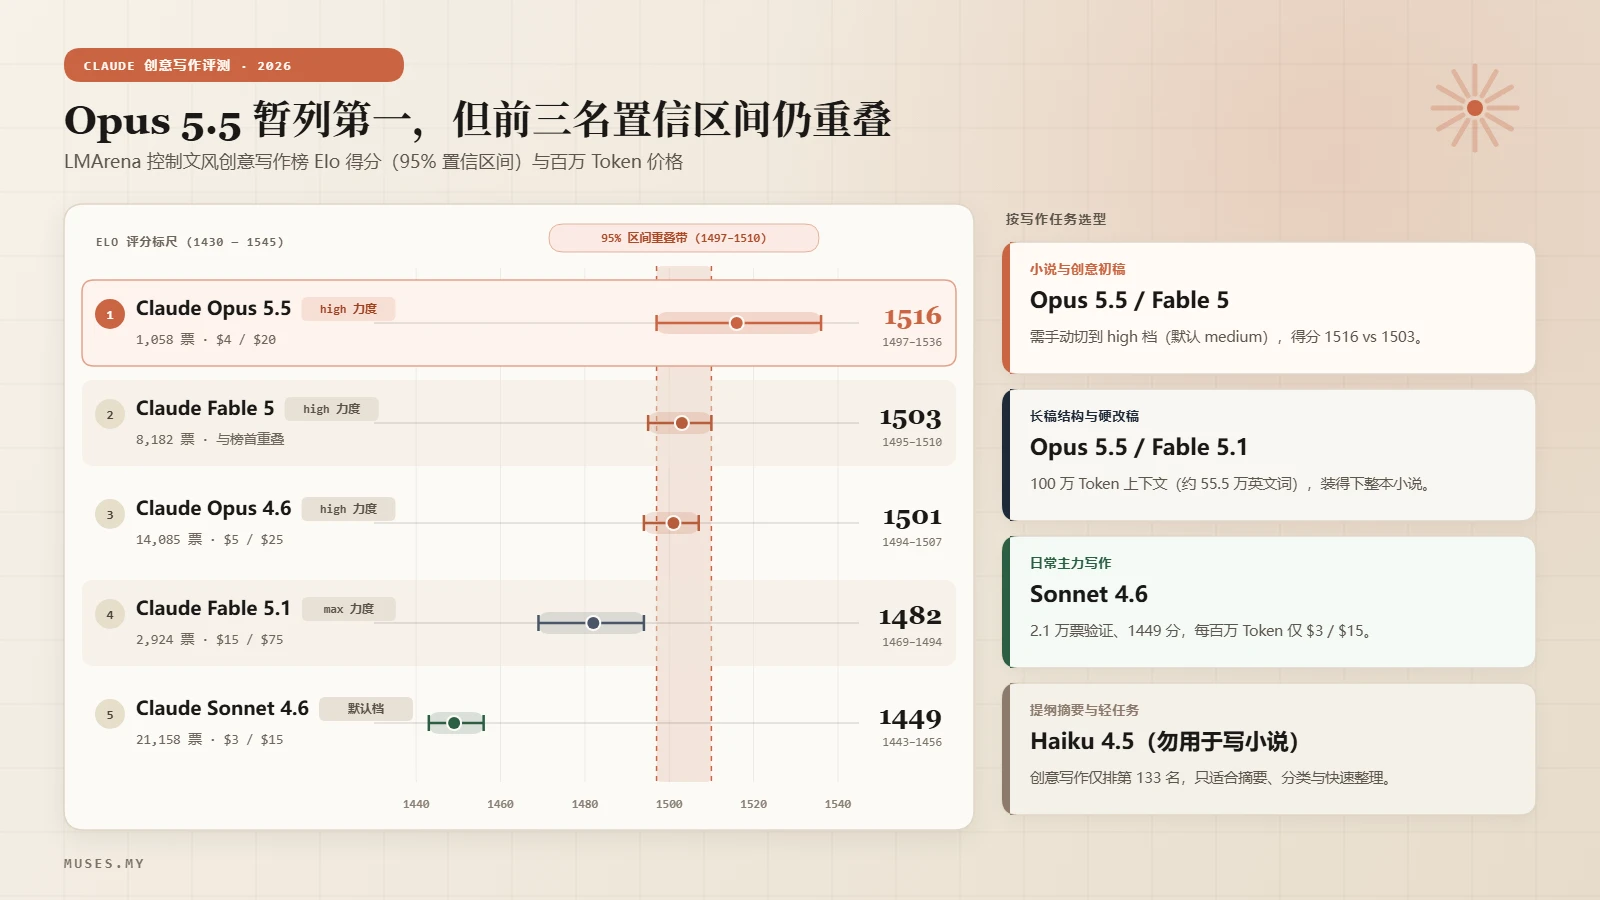
先說結論,表格放到後面:最新的 Opus,在創意寫作上是 Claude 裡分數最高的,領先還沒站穩。LMArena 控制文風后的創意寫作排行榜,快照日期 2026 年 10 月 2 日,Claude Opus 5.5 在 high 力度上得 1516。它的置信區間與 high 力度的 Fable 5、high 力度的 Opus 4.6 重疊,而這一行只有 1,058 票,後兩者是 8,182 和 14,085。更新的 Fable 5.1 低於 Fable 5。更新的 Sonnet 5.5 票太少,還不能下結論。
這跟名字給人的聯想對不上。Anthropic 現在的建議是,多數工作從 Opus 5.5 開始,更重的推理在 Opus 5.5 上把力度調高仍不夠時,再上 Fable 5.1。官方用例是智慧體程式設計、知識工作和長程任務。創意寫作不在其中。人類偏好投票還是落在了這裡。
我們做 Muses,一個寫作工作區,會持續跟蹤、接入前沿模型,因為一稿的成色取決於游標後面是誰。下面全部來自公開來源:LMArena 排行榜資料集、LiveBench,以及 Anthropic 的模型文件。資料到頭的地方,長稿能不能穩住、哪個模型拒得最少,這一頁會明說,而不是把缺口填上。
短答:寫作該用哪個 Claude?
| 你在做什麼 | 先用這個 | 每百萬 token 價格(入 / 出) | 為什麼 |
|---|---|---|---|
| 小說初稿、創意散文 | Claude Opus 5.5,力度 high | $4 / $20 | 控制文風后的創意寫作榜上,Claude 裡點估計最高。區間與 high 力度的 Fable 5、Opus 4.6 重疊,而 high 比 Opus 5.5 的預設高一檔 |
| 同一份活,但想要分數底下有更多票 | Claude Fable 5,力度 high | $10 / $50 | 1503 分,8,182 票,跟 Opus 5.5 落在同一條帶裡。Fable 5.1 不佔這個位置 |
| 長稿 | Claude Opus 5.5,力度 high | $4 / $20 | 壓過 high 力度的 Opus 4.7,區間不相交,也比舊 Opus 的 $5 / $25 便宜。用的是新分詞器,同樣視窗比 Opus 4.6 少裝下一部分書 |
| 對照文風表做修改 | Claude Fable 5;預算停在 Opus 價位就用 Opus 4.8 | $10 / $50,或 $5 / $25 | LiveBench 指令遵循,max 力度:Fable 5 是 75.8,Fable 5.1 是 73.0,Opus 4.8 是 72.0。Opus 5.5 的 max 是 65.7 |
| 預算內的日常起草 | Claude Sonnet 4.6 | $3 / $15 | 票數夠讀。剛好壓過 Sonnet 5。現在的在售 Sonnet 5.5 只有 658 票,還排不上 |
| 量大、利害不大的文案 | Claude Haiku 4.5 | $1 / $5 | 一次起草大約四分錢,創意寫作榜第 133,也是該盯著的退役下限 |
若只能帶走一句:2026 年 10 月,初稿先用把力度調到 high 的 Opus 5.5;若更信那份底下有幾千張票的分數,用 Fable 5;活是改稿、又按 Opus 的價格付錢,用 Opus 4.8;天天寫,用 Sonnet 4.6。在自己的頁面上試過這張短名單再決定。它不是釋出順序,也不是「永遠買最新的」。
寫作者要面對的 2026 Claude 產品線
當前這一家,摘自 Anthropic 的模型總覽。拿不準時,Anthropic 說從 Opus 5.5 開始;你自己的測試裡,把 Opus 5.5 的力度調高仍不夠,再用 Fable 5.1。
| 模型 | 上下文 | 最大輸出 | 每百萬 token 價格(入 / 出) | 思考 | 預設力度 | 可靠知識截止 |
|---|---|---|---|---|---|---|
| Claude Fable 5.1 | 1M | 128K | $10 / $50 | 自適應,始終開 | high | 2026 年 6 月 |
| Claude Opus 5.5 | 1M | 128K | $4 / $20 | 自適應,始終開 | medium | 2026 年 6 月 |
| Claude Sonnet 5.5 | 1M | 128K | $2 / $10 | 自適應 | high | 2026 年 6 月 |
| Claude Haiku 4.5 | 200K | 64K | $1 / $5 | Extended | 不支援 | 2025 年 2 月 |
仍可呼叫、被 Anthropic 標成遺留而不是當前款的:Fable 5、Opus 5、Opus 4.8、4.7、4.6、4.5、Sonnet 5、Sonnet 4.6。Opus 5 和 Opus 4.8 到 4.5 是 $5 和 $25,高於 Opus 5.5。Fable 5 與 Fable 5.1 同價,$10 和 $50。Sonnet 5 與 Sonnet 5.5 同價,$2 和 $10。Sonnet 4.6 仍是 $3 和 $15,比更新的 Sonnet 貴,不是更便宜。Sonnet 4.5 已經離開這張名單:2026 年 9 月 30 日棄用,現在還能調,11 月 30 日下線。
稿子要拿上下文視窗去量之前,有一個細節得先核對。Anthropic 從 Opus 4.7 起換了分詞器。按現在的分詞器,100 萬 token 大約相當於 55.5 萬英文詞;按舊的,同樣 100 萬能裝下大約 75 萬詞。Anthropic 的定價文件把這個增幅寫成:同一段文字大約多出 30% 的 token。Fable 5.1、Opus 5.5、Sonnet 5.5、Fable 5、Opus 5、Sonnet 5、Opus 4.8、Opus 4.7 都走新分詞器。Sonnet 4.6、Opus 4.6、Sonnet 4.5、Haiku 4.5 走舊的。Opus 5.5 上那個寫著 1M 的視窗,能裝下的小說,明顯少於 Opus 4.6 上同樣寫著 1M 的視窗。
控制文風后的排行榜實際在說什麼
LMArena 收集匿名的兩兩人類偏好投票,擬合 Bradley-Terry 評分。文風控制會把那些靠排版贏票、文筆未必更好的習慣調下去,比如篇幅、大段標題和專案符號。要評散文質量,該看的是控制文風后的數字。下面來自文字競技場的 style_control 子集、creative_writing 類別,資料在 LMArena 排行榜資料集,快照日期 2026 年 10 月 2 日。表裡的分數和區間,是從那份檔案四捨五入到整數。
| 模型 | 競技場變體 | 評分 | 名次 | 95% CI | 票數 |
|---|---|---|---|---|---|
| Claude Opus 5.5 | claude-opus-5.5-high | 1516 | 2 | 1497–1536 | 1,058 |
| Claude Fable 5 | claude-fable-5-high | 1503 | 3 | 1495–1510 | 8,182 |
| Claude Opus 4.6 | claude-opus-4-6-high | 1501 | 4 | 1494–1507 | 14,085 |
| Claude Opus 4.7 | claude-opus-4-7-high | 1489 | 6 | 1482–1496 | 11,812 |
| Claude Fable 5.1 | claude-fable-5.1-max | 1482 | 10 | 1469–1494 | 2,645 |
| Claude Opus 5 | claude-opus-5-high | 1471 | 13 | 1465–1478 | 13,263 |
| Claude Opus 4.8 | claude-opus-4-8-high | 1470 | 17 | 1463–1476 | 12,798 |
| Claude Sonnet 4.5 | claude-sonnet-4-5-20250929 | 1454 | 33 | 1448–1460 | 12,367 |
| Claude Sonnet 4.6 | claude-sonnet-4-6 | 1449 | 38 | 1443–1456 | 12,339 |
| Claude Sonnet 5.5 | claude-sonnet-5.5-xhigh | 1447 | 42 | 1424–1471 | 658 |
| Claude Sonnet 5 | claude-sonnet-5-high | 1435 | 65 | 1428–1442 | 9,413 |
| Claude Haiku 4.5 | claude-haiku-4-5-20251001 | 1388 | 133 | 1383–1393 | 24,158 |
力度標籤決定你實際跑到的是不是這一行。
Opus 5.5 這一行是 high。它的 API 預設是 medium。不填這個引數,得不到這個分數。Fable 5、Opus 4.6、Opus 4.7、Opus 4.8、Sonnet 5 在表裡是 high,也是這些模型的預設。Fable 5.1 在榜上只有 max,比它的預設 high 高一檔,所以開箱即用的 Fable 5.1 不是表裡這一行。Sonnet 5.5 只有 xhigh,高於預設的 high,658 票。Sonnet 4.6、Sonnet 4.5、Haiku 4.5 在榜上沒有力度字尾。Haiku 4.5 根本不支援力度引數。
Opus 5.5 在 Claude 裡的第一,是點估計,不是拉開的勝負。 區間 1497–1536 與 Fable 5(1495–1510)、high 力度的 Opus 4.6(1494–1507)重疊。它確實壓過 high 力度的 Opus 4.7(1482–1496),區間不相交。八月這一頁推薦給長散文的那個模型,被邁過去了,這一步是真的。家族外面也有人:high 力度的 Gemini 4 Argon 得 1519,排第 1,區間 1499–1538,跟 Opus 5.5 也重疊。這篇文章不做跨廠比較。那一層高處並不只有 Claude。
Fable 5.1 沒有接過 Fable 5 的位置。 公佈出來的只有 max 力度,1469–1494;high 力度的 Fable 5 是 1495–1510。兩個區間不相交。這跟「更新、而且還開到 max」會讓人以為的方向相反。但書要寫上:兩邊力度不同,Fable 5.1 的預設 high 並不在榜上。
Sonnet 的排序比八月安靜,而且其中一款正在離開。Sonnet 4.5 的 1454(1448–1460)仍然壓過 high 力度的 Sonnet 5,1435(1428–1442),區間不相交。Sonnet 4.5 已棄用,2026 年 11 月 30 日下線,所以這個發現不是現在該去用的型號。Sonnet 4.6 的 1449(1443–1456)也壓過 Sonnet 5,邊界只差 1 分,1443 對 1442。是真的,也很薄。Sonnet 5.5 的區間 1424–1471 把 Sonnet 4.6、Sonnet 5、Sonnet 4.5 都蓋住了。658 票定不了這件事。
high 力度的 Opus 4.7,1482–1496,壓過 high 力度的 Opus 4.8,1463–1476,區間不相交。不帶 -high 字尾的那兩行也一樣:Opus 4.7 是 1483(1476–1490),壓過 Opus 4.8 的 1463(1457–1470)。在仍賣 $5 和 $25 的型號裡,這次舊的順序反轉還在。high 力度的 Opus 5.5 同樣壓過 high 力度的 Opus 4.7,而且更便宜。
偏好評分是一根軸。LiveBench 的題集仍是 2026-06-25,模型行於 2026 年 10 月 7 日讀到。語言項和指令遵循項分開打分,兩者對排序意見不合。下面每一行,都是公佈表格上實際寫著的那個力度。
語言項上,max 力度的 Fable 5 以 90.7 領著 Claude 這幾行。max 力度的 Fable 5.1 是 89.5。max 力度的 Opus 5 是 88.7。max 力度的 Opus 5.5 是 86.3。最新的 Opus 不是語言項的頭名,也落在它換掉的那一款 Opus 後面。
指令遵循上,順序打散。high 力度的 Gemini 3.8 Flash 以 81.4 領著公佈出來的這張單子。Claude 裡最高的是 max 力度的 Fable 5,75.8,然後是 max 力度的 Fable 5.1,73.0,然後是 max 力度的 Opus 4.8,72.0。Opus 5.5 公佈出來較高的一行是 xhigh 的 67.0,max 是 65.7。xhigh 的 Opus 4.7 是 66.7。max 的 Opus 5 是 63.8。Sonnet 5.5 在 xhigh 是 70.5,在 max 是 56.8,擺幅很大,所以不能拿一個 Sonnet 5.5 的數字代表這個模型。「會不會寫」沒有一個單一數字。
限度還是那些,票數的跨度更大了。競技場評分量的是匿名投票者在短的兩兩比較裡更喜歡什麼,不是什麼對你的書更有用。表裡的票數從 658 到 24,158。Opus 5.5 的評分建立在 1,058 票上。用區間把短名單收窄,不要只看點估計,然後在自己的頁面上試這份短名單。
不,寫作榜上領先的那個,不是 Anthropic 的創意寫作模型
Fable 5 這個名字曾經讓人以為它是為創意寫作做的。Opus 5.5 坐上寫作榜的高處,則會讓人產生另一種以為:Anthropic 讓你預設先用的那個,是按散文調過的。文件說的是另一回事。
模型總覽說,多數工作從 Claude Opus 5.5 開始;吃重的推理和長程智慧體工作,或者你自己的測試裡把 Opus 5.5 的力度調高仍不夠,再用 Claude Fable 5.1。Opus 5.5 模型頁把它寫成面向長程智慧體程式設計和知識工作。Fable 5.1 模型頁寫的是更強的長程智慧體程式設計、多步研究,以及文件工作,輸入和輸出價格與 Fable 5 相同。這些用例裡都沒有創意寫作。
定位和成績仍然分開,只是不再是八月那種分開法。八月寫作榜頂上的,是更貴的通用模型 Fable 5,2026 年 6 月 9 日釋出。十月點估計最高的,是 Anthropic 已經建議多數人先用的 Opus 5.5,2026 年 9 月 22 日釋出,價格低於 Fable,也低於 Opus 5。這是一次有用的巧合。它仍然是巧合。Fable 5.1 於 2026 年 9 月 1 日釋出,在 Anthropic 自己的選型指南里是能力上的那一檔,在這張寫作榜上它並沒有寫得比 Fable 5 更好。
起草、修改、長稿,是三份不同的活
把「寫作」當成一種能力,就會選出糟糕的模型。至少,它是三份活。
起草獎賞的是人們真正更願意讀的東西,也就是競技場在量的。從提示或大綱裡生出新散文,創意寫作榜指向 high 力度的 Opus 5.5,high 力度的 Fable 5 和 Opus 4.6 落在同一個區間裡。若你不把 Opus 5.5 調到 high,你跑的就不是掙來 1516 的那個配置。
修改完全是另一種技能。改稿意味著精確遵循指令:保住文風,砍 15%,別動對話,套上這份文風表。那是指令遵循,LiveBench 會把散文排序重洗。max 力度的 Fable 5 以 75.8 領著 Claude 這幾行。max 力度的 Fable 5.1 是 73.0。max 力度的 Opus 4.8 是 72.0。Opus 5.5 在 xhigh 是 67.0,在 max 是 65.7,公佈出來的兩行都落在 Opus 4.8 後面,token 價格更低。這兩個裡哪個「更好」,完全取決於你交給它的是哪一份活。LiveBench 這些行是 max 或 xhigh,不是對齊過的 API 預設,所以這段差距是拿來開測的起點,不是你已經復現過的結果。
長稿靠的是一次會話裡的上下文和一致性,公開資料在這裡就到頭了。上下文容量有文件:100 萬 token,按現在的分詞器大約 55.5 萬詞。Opus 5.5、Fable 5.1、Sonnet 5.5 用的就是這套分詞器。一致性沒有。沒有公開基準去測一個模型的文風會不會在 6 萬字的工程裡漂、會不會到第 20 章忘掉角色的說話方式、會不會在第四十輪修改後悄悄把句法抹平。我們用這些模型幹活時有看法。看法不是測量,所以不是發現。我們正在為這件事搭結構化測試,有值得發表的結果時會補到這裡。
一輪四回合的起草,實際要花多少錢
下面是一套推演,不是實測。我們沒有拿這些會話去做基準。我們只是把 Anthropic 公佈的價格套到一個說得通的會話形狀上,好讓相對成本看得見。你的 token 數會不一樣。
| 假設 | 取值 |
|---|---|
| 每會話生成次數 | 4(一稿,三輪修改) |
| 每次生成的輸入 | 約 4,000 token(說明、當前稿、筆記) |
| 每次生成的輸出 | 約 1,400 token |
| 會話合計 | 輸入 16,000,輸出 5,600 |
按舊分詞器,1,400 輸出 token 大約是 1,050 個英文詞;按現在的,更接近 780。套上公佈的每百萬 token 單價:
| 模型 | 產出詞數 | 輸入費用 | 輸出費用 | 每會話費用 |
|---|---|---|---|---|
| Claude Fable 5 與 Fable 5.1 | ≈780 | $0.160 | $0.280 | $0.44 |
| Claude Opus 5、4.8 與 4.7 | ≈780 | $0.080 | $0.140 | $0.22 |
| Claude Opus 5.5 | ≈780 | $0.064 | $0.112 | $0.18 |
| Claude Sonnet 4.6 | ≈1,050 | $0.048 | $0.084 | $0.13 |
| Claude Sonnet 5 與 Sonnet 5.5 | ≈780 | $0.032 | $0.056 | $0.09 |
| Claude Haiku 4.5 | ≈1,050 | $0.016 | $0.028 | $0.04 |
「產出詞數」這一列不能跨分詞器代際比較。同樣 5,600 輸出 token,在舊分詞器上能多買大約三分之一的英文詞。Opus 4.6 仍走舊分詞器,仍賣 $5 和 $25,同樣 $0.22 的輸出預算能拿到大約 1,050 詞。費用對詞數,只在同一代分詞器裡讀。
有兩處調整會改畫面。第一處是提示快取。快取讀取在這些模型的大多數上按基礎輸入價的 10% 計,Opus 5.5 是 5%(每百萬 token $0.20),Fable 5.1 是 2.5%(每百萬 token $0.25)。Fable 5 仍是 10%(每百萬 token $1)。在長稿上反覆改,幾乎是它的理想場景,但只對提示裡不動的那一段成立:系統提示、你一次性載入的源材料、以及只追加、不回頭改的對話歷史。改寫過的稿貼回提示靠近頂部,就不再匹配已快取的字首。同一段文字追加在末尾,穩定部分還在。任何會改字首的東西,時間戳、重排過的筆記、改過的系統指令,都會把折扣扔掉。Anthropic 的 Batch API 是第二個槓桿,雙向五折。它是非同步的,對互動式起草沒有用。排行榜上 Sonnet 4.6 旁邊若出現 $1.50 和 $7.50,那是這個半價,不是 $3 和 $15 的標價。
第二處調整方向相反。思考 token 按輸出計費。Fable 5.1 和 Opus 5.5 上,自適應思考始終開著,關不掉,所以你為它付多少,靠的是力度。一個硬的結構問題會比一次簡單重寫產出更多思考。上面的輸出列假定的是一輪順當的起草。看你真實使用的第一週,而不是信任何公佈的估算,包括這一份。
力度設定:多數人沒用上的那根槓桿
Anthropic 的力度文件裡仍有那句話,得到的注意力配不上它的分量:調力度,往往比換模型更划算。力度是請求引數。設成該模型的預設,跟把這個引數省掉,是同一種行為。
預設不再是一個值。Opus 5.5 預設 medium。其他支援力度的當前模型,預設都是 high。Haiku 4.5 不支援這個引數。Fable 5.1、Fable 5、Opus 5.5、Opus 5、Opus 4.8、Opus 4.7、Sonnet 5.5、Sonnet 5 有五檔,從 low 到 max。Opus 4.6 和 Sonnet 4.6 有 max,文件沒有列出 xhigh。
對寫作來說,力度對應的是一件眼熟的事。更高的力度買的是第一句之前更多的籌劃:更好的結構決定、對長 brief 更穩的處理、更在意你要的是什麼。它也更貴、更慢。更低的力度產出更快的回合,背後的思量更少。
實際怎麼設,取決於你選了哪一款,因為榜上那些行並不都是預設。
Opus 5.5 的創意寫作分數是 high 那一行,比預設高一檔。要對上那張榜,動作是往上調,不是把引數空著。只在你已經決定丟掉的快改上走到 low;結構活再走到 xhigh:重排一章、修一段總是塌掉的、同時啃一份約束很多的 brief。Anthropic 對這個模型的說明是,省掉力度的請求,會比在 Opus 5 上低一檔執行。
Fable 5、Opus 4.7、Opus 4.8、Sonnet 5 上,high 是預設,也是上表裡的那一行。這些型號上,動作仍是快的初稿往下調,結構才是問題時再往上。Anthropic 註明,Fable 5 在更低力度上仍然能打,而且常常勝過更早模型上的 xhigh。
Fable 5.1 在創意寫作榜上只有 max,高於預設的 high。Sonnet 5.5 只有 xhigh,高於預設的 high。按預設跑這兩款,就不是表裡那個配置。我們沒有跨力度的寫作品質實測,所以上面全部是拿來試的起點。
拒稿、口氣,以及「Sonnet 變冷了」的抱怨
寫作者抱怨一個模型時,常常把兩件事揉在一起:拒絕請求,和答應了卻寫得很冷。
口氣這件事,社群裡「Sonnet 5 讀起來比 Sonnet 4.5 更幹」仍是軼事。值得再提一次,是因為十月的榜指向同一方向:high 力度的 Sonnet 5 比 Sonnet 4.5 低 19 分,1435 對 1454,區間不相交。Sonnet 4.5 於 2026 年 11 月 30 日下線,所以你想換回去的那一款,時限已經寫上了。留下來的 Sonnet 4.6 也壓過 Sonnet 5,邊界只差 1 分。軼事加上對得上的數字,不是證明。它比氣氛多,也不是去用一款已經棄用的模型的理由。
拒稿這件事,寫在文件裡的事實比八月更寬。Anthropic 寫明,Claude Fable 5.1、Fable 5、Opus 5.5、Opus 5 和 Sonnet 5.5 帶有可以拒絕請求的安全分類器。Opus 5.5 的分類器覆蓋比 Opus 5 更寬的類別,包括生物、網路安全,以及推理提取。除此之外,沒有公開基準去測創意寫作任務上的拒絕率,所以「哪個拒得最少」的排名會是編的。我們不會去編。
真正有用的是把場面說清。宣告這是小說,點明體裁。給出類型和想定的讀者。解釋這場難寫的戲在故事裡做什麼:它讓角色付出什麼,它為後面鋪了什麼。按這場戲真正需要的細緻程度去要,而不是按上限去要。這些是人類編輯在讀一章難的之前會想知道的。它們是讓請求變得可讀的語境。
哪種寫作者,用哪個 Claude
先看預算。 Sonnet 4.6,每百萬 token $3 和 $15。創意寫作榜上,它剛好壓過 Sonnet 5,而 Sonnet 5 是 $2 和 $10。若賬單比這點薄的優勢更要緊,Sonnet 5 是更便宜、而且分數讀得出來的選擇。Sonnet 5.5 是現在的在售 Sonnet,價格與 Sonnet 5 相同,658 票說不出它寫得更好還是更差。Haiku 4.5 更便宜,排第 133。
小說作者和長篇非虛構。 Opus 5.5,若要對上榜上的配置,把力度設成 high。它壓過 high 力度的 Opus 4.7,區間不相交,價格是 $4 和 $20,Opus 4.7 是 $5 和 $25。規劃上下文裡要留多少稿時,把新分詞器算進去。若你要的是建立在 8,182 票而不是 1,058 票上的那份分數,Fable 5 是升級,token 價格是 Opus 5.5 的兩倍半。在仍賣 $5 和 $25 的型號裡,Opus 4.7 仍然壓過 Opus 4.8。
日常內容和大量起草。 預設 Sonnet 4.6,真正要緊的篇目再上 high 力度的 Opus 5.5。一輪起草大約 $0.13,一天一篇寫一個月,對照它省下的時間,只是舍入誤差。模型選誰,遠沒有你是否真的去改輸出重要。若你要的只是一稿拿來反應,在我們的 AI 文字生成 裡描述它,它會作為草稿在工作區開啟,不用配 API。
編輯和改寫。 Fable 5,憑的是 LiveBench 指令遵循上的差距:max 力度 75.8,對 Opus 5.5 的 max 65.7 和 xhigh 67.0。預算停在 Opus 價位,公佈出來仍領先 Opus 5.5 的是 max 力度的 Opus 4.8,72.0。Opus 4.8 的 API 預設是 high,LiveBench 沒有公佈它的 high 力度行,所以 72.0 比省掉引數時高一檔。如果你的活是套文風表、把聲音穩住、砍你指定要砍的,從這裡開始,拿一章你已經很熟的去核。
寫作日裡的大多數摩擦,不是模型。是稿在一個標籤頁,研究在另一個,大綱在第三個,哪邊都沒有版本歷史。這就是我們做 Muses 要修的:一個寫作工作區,草稿、筆記、源材料和 AI 協助的修改住在同一個專案裡,走錯一輪修改還能退回去。後面的模型由平臺選、由平臺跟上,所以上面那些按模型微調,不是你要自己去配的。免費試試。
模型退役:護住你的寫作工作流
模型推薦會過期。上面幾個選項裡有更老的型號,而這篇文章八月拿來當發現的一款,現在有了下線日。
Sonnet 4.5 於 2026 年 9 月 30 日棄用,2026 年 11 月 30 日下線。建議的替換型號是 claude-sonnet-5-5。它在創意寫作榜上仍然高於 Sonnet 5。這不是把工作流建在它上面的理由。這裡討論的型號裡,只有它有確定的下線日。
Haiku 4.5 仍被列為活躍。棄用頁給的下限是不早於 2026 年 10 月 15 日,並且沒有棄用記錄。Anthropic 對公開發布的模型,退役前至少提前 60 天通知。若要在 10 月 15 日退役,這份通知現在就該已經發出。頁面上沒有,所以 10 月 15 日還沒有變成排定的退役日。它仍是大量起草那個選項裡,公佈下限最近的一款。這一頁還提到的型號裡,下一個下限是 Opus 4.5,不早於 2026 年 11 月 24 日。
其餘更寬裕。Sonnet 4.6 到 2027 年 2 月 17 日。Opus 4.6 到 2027 年 2 月 5 日。Opus 4.7 到 2027 年 4 月 16 日。Opus 4.8 到 2027 年 5 月 28 日。Sonnet 5 到 2027 年 6 月 30 日。Fable 5 到 2027 年 6 月 9 日。Opus 5 到 2027 年 7 月 24 日。Fable 5.1 到 2027 年 9 月 1 日。Opus 5.5 到 2027 年 9 月 22 日。Sonnet 5.5 到 2027 年 9 月 28 日。這些都是「不早於」,不是退役公告。
若你直接調 API,釘死確切的模型 ID。Anthropic 註明,每個 Claude 模型 ID 都是釘死的快照,包括 4.6 代起那些不帶日期的 ID,所以 claude-opus-5-5 點名的是一個特定模型,也會一直點名它。透過應用使用 Claude 的寫作者沒有這種控制,所以在斷定「模型在我眼皮底下變了」之前,先核對自己的工具實際在調什麼。這些模型輪換時,本頁會更新。
我們怎麼讓這一頁保持新
最近核對:2026 年 10 月 7 日。
我們每月複查這一頁,每次核三件事:產品線和 ID、公佈的定價、排行榜快照。評分變動到足夠改推薦時,推薦跟著改,頁頂的更新日期也跟著動。這一頁的八月版本寫過,最新的 Claude 並不是最適合寫作的 Claude。十月的快照不再支撐那句話,所以那句話改了。
來源,全部公開:
- LMArena 排行榜資料集 —— 文字競技場,
style_control子集,creative_writing類別,快照日期 2026-10-02。Bradley-Terry 評分來自匿名兩兩人類偏好投票。表中整數由該檔案四捨五入。 - LiveBench —— 題集 2026-06-25。語言項和指令遵循項的類別平均,2026 年 10 月 7 日讀取,每一行都標明瞭力度。
- Anthropic 模型總覽 —— 上下文視窗、輸出上限、定價、思考模式、預設力度、知識截止、分詞器說明。
- Anthropic 定價 —— 每百萬 token 單價、提示快取倍率、Batch API 折扣。
- 如何選對模型 與 力度 —— 力度分檔,以及「調力度還是換模型」的指引。
- 拒答與回退 —— 哪些當前型號帶有安全分類器。
- 模型退役 —— 生命週期狀態、退役日期、通知政策。
若你要的是手藝那一側而不是模型那一側,我們這篇如何提高寫作水平講的是起草—拉開距離—聽反饋—再改這一套迴圈,上面這些模型都可以嵌進去;對《寫作這回事》的細讀,則講機器該不該、該在房間的哪一層。
常見問題
哪個 Claude 模型最適合寫作?
在控制文風后的創意寫作榜上,Claude 裡分數最高的是 high 力度的 Opus 5.5,1516 分,但 95% 區間 1497 到 1536 與 high 力度的 Fable 5(1503,區間 1495 到 1510)和 high 力度的 Opus 4.6(1501,區間 1494 到 1507)重疊。領先還沒站穩。high 也不是開箱即用:Opus 5.5 的預設是 medium。更新的 Fable 5.1 在 max 力度上是 1482,區間落在 Fable 5 下面。Sonnet 5.5 票太少,排不上。
寫長文,Claude Opus 5.5 和 Sonnet 5.5 誰更好?
就現有分數而言,是 Opus 5.5。high 力度 1516,區間 1497 到 1536。Sonnet 5.5 在榜上只有一條 xhigh,1447,658 票,區間 1424 到 1471,兩個區間不相交,但這條 Sonnet 太薄,不能當成已經排完的名次。Opus 5.5 每百萬 token 4 美元和 20 美元,Sonnet 5.5 是 2 美元和 10 美元。high 不是 Opus 5.5 的預設,預設是 medium;xhigh 也不是 Sonnet 5.5 的預設,預設是 high。
寫小說、寫創意,該用哪個 Claude?
點估計最高的是 high 力度的 Claude Opus 5.5,1516。若要票數更紮實的鄰近分數,high 力度的 Fable 5 是 1503,8,182 票,Opus 5.5 那一行是 1,058 票,兩個區間重疊。max 力度的 Fable 5.1 不佔這個位置:1482,區間 1469 到 1494,跟 Fable 5 不相交。寫小說別用 Haiku 4.5,它在那張榜上排第 133。
Opus 5.5 或 Fable 5 真是為創意寫作做的嗎?
不是。Anthropic 把 Opus 5.5 寫成面向長程智慧體程式設計和知識工作的模型,並建議多數工作從它開始。Fable 5.1 面向吃重的推理和長程智慧體工作,Fable 5 當初也是這個定位。創意寫作不在官方用例裡。偏好分數是真的,說的是結果,不是設計意圖。
日常寫作預設該用哪個 Claude?
若要一份票數夠讀的文筆分數,用 Sonnet 4.6。每百萬 token 3 美元和 15 美元,得分 1449,區間 1443 到 1456,剛好壓過 high 力度的 Sonnet 5(1435,區間 1428 到 1442)。Sonnet 5.5 是現在的在售 Sonnet,更便宜,2 美元和 10 美元,但創意寫作只有一條 xhigh,658 票,區間 1424 到 1471,把上面兩個分數都蓋住了。票太少,分不出。
Claude 能寫完一本書嗎?
它裝得下一本。按現在的分詞器,100 萬 token 的上下文大約相當於 55.5 萬英文詞,整本小說塞進一次對話裡夠了。一次生成就寫出一本好書是另一回事,沒有模型能解決。真正能跑通的工作流是一章一章來:大綱和文風表留在上下文裡,改完這一章再往下。
用 Claude 怎麼保住自己的文風?
把你自己的文字交給它去處理,而不是讓它按你的風格憑空寫。貼兩三段你寫過的,說清你守的規則,要的是修改意見和結構筆記,不是成品段落。然後用自己的話重寫它的輸出。文風更扛得住修改,扛不住代寫,所以最後一稿留給自己。
為什麼有的創意寫作請求會被拒,哪個模型拒得最少?
Anthropic 寫明,Claude Fable 5.1、Fable 5、Opus 5.5、Opus 5 和 Sonnet 5.5 帶有可以拒絕請求的安全分類器。拒稿行為因模型而異,但沒有公開基準去測創意寫作場景下的拒絕率,排個名就是猜。管用的辦法是把語境說清,不是繞過去。宣告這是小說,點明類型和想定的讀者,解釋這場難寫的戲在故事裡做什麼,再按這場戲真正需要的細緻程度去要。