Bestes Claude-Modell zum Schreiben (2026): Opus 5.5 liegt vorn, doch das Rennen ist offen
Opus 5.5 führt die Claude-Modelle beim kreativen Schreiben an, doch der Vorsprung vor Fable 5 und Opus 4.6 ist statistisch nicht gesichert. Unsere Empfehlungen für Rohfassung, Lektorat und Alltagstexte inklusive Preisen.
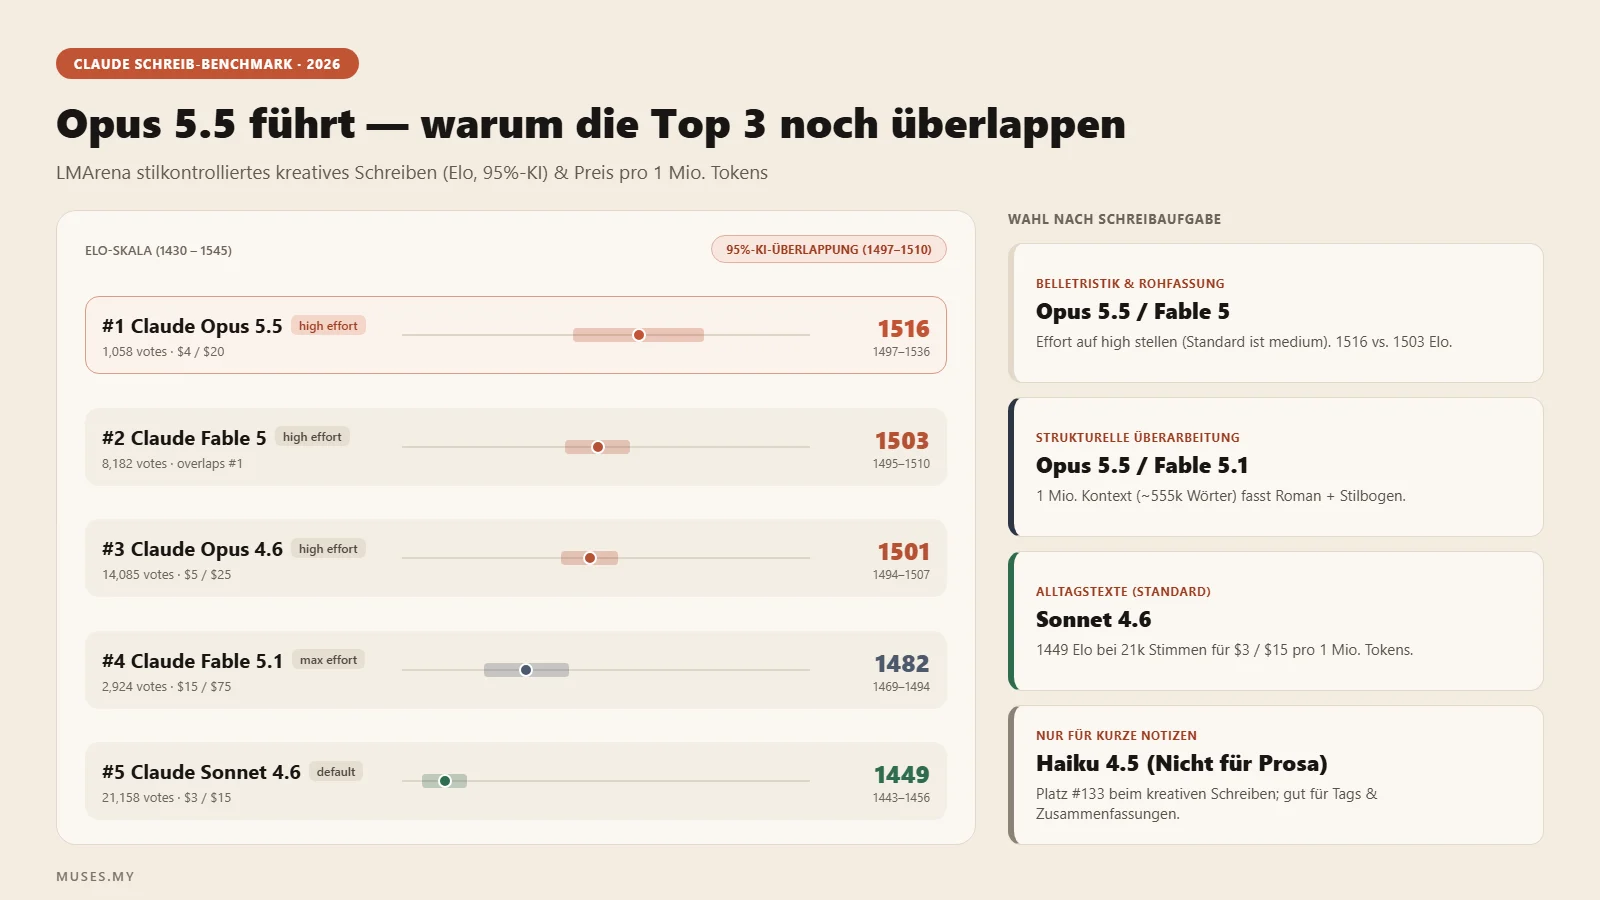
Die Kurzfassung vor den Tabellen: Das neueste Opus erzielt beim kreativen Schreiben den höchsten Wert unter allen Claude-Modellen, doch der Vorsprung ist noch nicht in Stein gemeißelt. Auf der stilbereinigten Bestenliste für kreatives Schreiben von LMArena (Datenstand: 2. Oktober 2026) liegt Claude Opus 5.5 mit der Einstellung high bei 1516 Punkten. Sein Konfidenzintervall überschneidet sich jedoch mit Claude Fable 5 (high) und Claude Opus 4.6 (high) – und hinter dem Wert von Opus 5.5 stehen bislang 1.058 Stimmen, verglichen mit 8.182 und 14.085 Stimmen bei den beiden anderen. Das neuere Fable 5.1 schneidet schlechter ab als Fable 5. Für das neuere Sonnet 5.5 reichen die Stimmen noch nicht für eine verlässliche Einordnung.
Nichts davon lässt sich aus den Modellnamen ablesen. Anthropics aktuelle Empfehlung lautet, für die meisten Aufgaben mit Opus 5.5 zu beginnen und erst dann auf Fable 5.1 zu wechseln, wenn anspruchsvolle Denkaufgaben selbst bei höherem Rechenaufwand nicht zufriedenstellend gelöst werden. Die offiziellen Einsatzgebiete sind Agenten-Programmierung, Wissensarbeit und mehrstufige Projekte. Kreatives Schreiben taucht dort nicht auf. Die Abstimmungsergebnisse der Leserinnen und Leser sprechen dennoch eine klare Sprache.
Wir entwickeln Muses, eine Schreibumgebung mit integrierter KI, und prüfen fortlaufend neue Sprachmodelle, weil die Qualität eines Entwurfs unmittelbar davon abhängt, welches Modell hinter dem Cursor arbeitet. Alle Zahlen in diesem Artikel stammen aus öffentlich zugänglichen Quellen: dem LMArena-Datensatz, LiveBench und der Modell-Dokumentation von Anthropic. Wo öffentliche Messdaten fehlen – etwa bei der Stimmigkeit über ein ganzes Romanmanuskript hinweg oder bei den Ablehnungsquoten –, benennen wir diese Lücke offen, statt sie mit Vermutungen zu füllen.
Kurzantwort: Welches Claude-Modell für welche Schreibaufgabe?
| Deine Aufgabe | Empfohlener Einstieg | Preis / MTok (Ein- / Ausgabe) | Warum |
|---|---|---|---|
| Rohfassung für Belletristik und kreative Prosa | Claude Opus 5.5, Effort high | $4 / $20 | Höchster Punktwert unter den Claude-Modellen auf der stilbereinigten Schreib-Bestenliste. Das Intervall überlappt mit Fable 5 und Opus 4.6 auf high; high liegt eine Stufe über der Voreinstellung von Opus 5.5 |
| Dieselbe Aufgabe, aber mit breiterer Datenbasis | Claude Fable 5, Effort high | $10 / $50 | 1503 Punkte aus 8.182 Stimmen, im selben Konfidenzband wie Opus 5.5. Fable 5.1 erreicht diesen Platz nicht |
| Lange Manuskripte | Claude Opus 5.5, Effort high | $4 / $20 | Schlägt Opus 4.7 auf high ohne Intervallüberlappung und ist günstiger als der alte Opus-Preis von $5 / $25. Durch den neuen Tokenizer passt allerdings etwas weniger Buchtext ins Fenster als bei Opus 4.6 |
| Überarbeitung nach Stilvorgaben (Stylesheet) | Claude Fable 5 oder Opus 4.8 zum Opus-Preis | $10 / $50 bzw. $5 / $25 | LiveBench Instruction Following auf max: Fable 5 mit 75,8, Fable 5.1 mit 73,0, Opus 4.8 mit 72,0. Opus 5.5 liegt auf max bei 65,7 |
| Alltägliches Schreiben mit kleinem Budget | Claude Sonnet 4.6 | $3 / $15 | Genügend Stimmen für eine klare Aussage. Knapp vor Sonnet 5. Das aktuelle Sonnet 5.5 hat erst 658 Stimmen und lässt sich noch nicht sicher einordnen |
| Großes Textvolumen mit geringem Risiko | Claude Haiku 4.5 | $1 / $5 | Rund vier Cent pro Schreibsitzung, Platz 133 auf der Schreib-Bestenliste und das Modell mit der nächsten Abschaltuntergrenze |
Wenn du dir nur einen Satz merken willst: Im Oktober 2026 ist das beste Claude-Modell für einen ersten Entwurf Opus 5.5 mit der Einstellung high, Fable 5 für alle, die sich lieber auf tausende Stimmen mehr verlassen, Opus 4.8 für präzises Redigieren zum Opus-Tarif und Sonnet 4.6 für das tägliche Schreiben. Teste diese Vorauswahl an deinen eigenen Kapiteln. Sie folgt weder der Veröffentlichungsreihenfolge noch der Regel „immer das neueste Modell kaufen“.
Das Claude-Portfolio 2026 für Autorinnen und Autoren
So sieht die aktuelle Modellfamilie laut Anthropics Modellübersicht aus. Wer unsicher ist, soll laut Anthropic mit Opus 5.5 starten und zu Fable 5.1 greifen, wenn eigene Tests mit höherem Effort auf Opus 5.5 nicht ausreichen.
| Modell | Kontext | Max. Ausgabe | Preis pro MTok (Ein- / Ausgabe) | Thinking | Standard-Effort | Verlässlicher Wissensstand |
|---|---|---|---|---|---|---|
| Claude Fable 5.1 | 1M | 128K | $10 / $50 | Adaptiv, immer aktiv | high | Juni 2026 |
| Claude Opus 5.5 | 1M | 128K | $4 / $20 | Adaptiv, immer aktiv | medium | Juni 2026 |
| Claude Sonnet 5.5 | 1M | 128K | $2 / $10 | Adaptiv | high | Juni 2026 |
| Claude Haiku 4.5 | 200K | 64K | $1 / $5 | Extended | Nicht unterstützt | Feb. 2025 |
Weiterhin über die API abrufbar, aber von Anthropic bereits als ältere Generation („Legacy“) geführt: Fable 5, Opus 5, Opus 4.8, 4.7, 4.6 und 4.5, Sonnet 5 sowie Sonnet 4.6. Opus 5 und Opus 4.8 bis 4.5 kosten $5 und $25 pro Million Token – also mehr als Opus 5.5. Fable 5 liegt wie Fable 5.1 bei $10 und $50. Sonnet 5 kostet wie Sonnet 5.5 genau $2 und $10. Sonnet 4.6 bleibt bei $3 und $15 und ist damit teurer als das neuere Sonnet. Sonnet 4.5 verlässt die aktive Auswahl: Es wurde am 30. September 2026 als veraltet markiert (deprecated), lässt sich derzeit noch aufrufen und wird am 30. November 2026 abgeschaltet.
Ein technisches Detail vorab, bevor du dein Manuskript gegen das Kontextfenster rechnest: Anthropic hat mit Opus 4.7 den Tokenizer gewechselt. Mit dem aktuellen Tokenizer entsprechen eine Million Token rund 555.000 englischen Wörtern; beim älteren Tokenizer passten rund 750.000 Wörter in dieselbe Million. Laut Anthropics Preisdokumentation benötigt derselbe Text rund 30 % mehr Token. Fable 5.1, Opus 5.5, Sonnet 5.5, Fable 5, Opus 5, Sonnet 5, Opus 4.8 und Opus 4.7 nutzen den neuen Tokenizer. Sonnet 4.6, Opus 4.6, Sonnet 4.5 und Haiku 4.5 arbeiten noch mit dem alten. In das 1M-Fenster von Opus 5.5 passt also spürbar weniger Romanmanuskript als in das 1M-Fenster von Opus 4.6, obwohl auf dem Papier dieselbe Zahl steht.
Was die stilbereinigte Bestenliste tatsächlich zeigt
LMArena sammelt anonyme Paarvergleiche echter Nutzerinnen und Nutzer und berechnet daraus ein Bradley-Terry-Rating. Die Stilbereinigung (style_control) rechnet Formatierungsgewohnheiten heraus, die in Abstimmungen oft Punkte bringen, ohne sprachlich besser zu sein – etwa bloße Textlänge oder exzessive Zwischenüberschriften und Aufzählungslisten. Die folgenden Zahlen stammen aus der Text-Arena, Untergruppe style_control, Kategorie creative_writing im LMArena-Leaderboard-Datensatz, Stand 2. Oktober 2026, gerundet auf ganze Zahlen.
| Modell | Arena-Variante | Wertung | Rang | 95-%-KI | Stimmen |
|---|---|---|---|---|---|
| Claude Opus 5.5 | claude-opus-5.5-high | 1516 | 2 | 1497–1536 | 1.058 |
| Claude Fable 5 | claude-fable-5-high | 1503 | 3 | 1495–1510 | 8.182 |
| Claude Opus 4.6 | claude-opus-4-6-high | 1501 | 4 | 1494–1507 | 14.085 |
| Claude Opus 4.7 | claude-opus-4-7-high | 1489 | 6 | 1482–1496 | 11.812 |
| Claude Fable 5.1 | claude-fable-5.1-max | 1482 | 10 | 1469–1494 | 2.645 |
| Claude Opus 5 | claude-opus-5-high | 1471 | 13 | 1465–1478 | 13.263 |
| Claude Opus 4.8 | claude-opus-4-8-high | 1470 | 17 | 1463–1476 | 12.798 |
| Claude Sonnet 4.5 | claude-sonnet-4-5-20250929 | 1454 | 33 | 1448–1460 | 12.367 |
| Claude Sonnet 4.6 | claude-sonnet-4-6 | 1449 | 38 | 1443–1456 | 12.339 |
| Claude Sonnet 5.5 | claude-sonnet-5.5-xhigh | 1447 | 42 | 1424–1471 | 658 |
| Claude Sonnet 5 | claude-sonnet-5-high | 1435 | 65 | 1428–1442 | 9.413 |
| Claude Haiku 4.5 | claude-haiku-4-5-20251001 | 1388 | 133 | 1383–1393 | 24.158 |
Entscheidend sind die Effort-Zusätze in der zweiten Spalte – sie bestimmen, ob du in der Praxis überhaupt das Modell aus der Tabelle ausführst.
Der Eintrag für Opus 5.5 lautet high. Seine Voreinstellung in der API ist jedoch medium. Wer den Parameter weglässt, bekommt nicht die Konfiguration, die diese Wertung erzielt hat. Fable 5, Opus 4.6, Opus 4.7, Opus 4.8 und Sonnet 5 laufen in der Tabelle auf high, was ihrer jeweiligen Standardeinstellung entspricht. Fable 5.1 taucht nur mit max auf, eine Stufe über seinem Standard high. Sonnet 5.5 ist nur mit xhigh vertreten, ebenfalls über dem Standard high, bei lediglich 658 Stimmen. Sonnet 4.6, Sonnet 4.5 und Haiku 4.5 tragen auf der Bestenliste keinen Effort-Zusatz; Haiku 4.5 unterstützt den Parameter gar nicht.
Der erste Platz von Opus 5.5 unter den Claude-Modellen ist ein Punktwert, kein klarer Abstand. Das Intervall 1497–1536 überschneidet sich sowohl mit Fable 5 (1495–1510) als auch mit Opus 4.6 auf high (1494–1507). Einen echten, überschneidungsfreien Vorsprung hat es dagegen vor Opus 4.7 auf high (1482–1496) – also genau jenem Modell, das im August noch die naheliegende Empfehlung für lange Prosa war. Außerhalb der Claude-Familie ist die Spitze ebenfalls eng: Gemini 4 Argon auf high liegt mit 1519 Punkten auf Rang 1 (Intervall 1499–1538) und überschneidet sich ebenfalls mit Opus 5.5.
Fable 5.1 tritt nicht in die Fußstapfen von Fable 5. Der einzige veröffentlichte Eintrag auf max liegt bei 1469–1494, während Fable 5 auf high zwischen 1495 und 1510 landet. Die Intervalle berühren sich nicht. Das widerspricht der Erwartung „neueres Modell plus maximaler Aufwand gleich besserer Text“ – allerdings mit der Einschränkung, dass die Effort-Stufen unterschiedlich sind und die Standardeinstellung high für Fable 5.1 auf der Bestenliste fehlt.
Bei den Sonnet-Modellen hat sich das Feld geordnet, wobei ein Modell bald ausscheidet. Sonnet 4.5 liegt mit 1454 (1448–1460) weiterhin ohne Überlappung vor Sonnet 5 auf high mit 1435 (1428–1442). Da Sonnet 4.5 am 30. November 2026 abgeschaltet wird, taugt es nicht mehr für neue Arbeitsabläufe. Sonnet 4.6 liegt mit 1449 (1443–1456) ebenfalls knapp vor Sonnet 5; die Intervallgrenzen trennt genau ein Punkt (1443 gegen 1442). Das Intervall von Sonnet 5.5 (1424–1471) ist wegen der 658 Stimmen noch so breit, dass es Sonnet 4.6, Sonnet 5 und Sonnet 4.5 komplett einschließt.
Opus 4.7 auf high (1482–1496) schlägt Opus 4.8 auf high (1463–1476) ohne Überlappung. Dasselbe gilt für die Varianten ohne -high-Suffix: Opus 4.7 erreicht 1483 (1476–1490) gegenüber 1463 (1457–1470) bei Opus 4.8. Unter den Modellen für $5 und $25 bleibt diese Umkehrung bestehen. Opus 5.5 auf high lässt Opus 4.7 auf high hinter sich und kostet weniger.
Menschliche Präferenz ist jedoch nur eine Achse. LiveBench (Fragensatz 2026-06-25, abgerufen am 7. Oktober 2026) misst Sprachgefühl (language) und Anweisungstreue (instruction following) getrennt – mit einer deutlich anderen Reihenfolge.
In der Kategorie Sprache führt Fable 5 auf max die Claude-Reihen mit 90,7 an, gefolgt von Fable 5.1 (max) mit 89,5, Opus 5 (max) mit 88,7 und Opus 5.5 (max) mit 86,3. Das neueste Opus ist hier also nicht der Spitzenreiter und bleibt hinter seinem direkten Vorgänger zurück.
Bei der Anweisungstreue wird die Liste kräftig durchgemischt. Gemini 3.8 Flash (high) führt das Gesamtfeld mit 81,4 an. Bestes Claude-Modell ist Fable 5 (max) mit 75,8, danach Fable 5.1 (max) mit 73,0 und Opus 4.8 (max) mit 72,0. Opus 5.5 erreicht auf xhigh 67,0 und auf max 65,7. Opus 4.7 liegt auf xhigh bei 66,7, Opus 5 auf max bei 63,8. Sonnet 5.5 schwankt stark zwischen 70,5 auf xhigh und 56,8 auf max. Es gibt keine einzelne Kennzahl für „gut im Schreiben“.
Die Grenzen solcher Ranglisten bleiben bestehen: Arena-Wertungen messen, was anonymen Abstimmenden im kurzen Direktvergleich besser gefallen hat, nicht was deinem Buch über 300 Seiten dient. Nutze die Konfidenzintervalle, um deine Auswahl auf zwei oder drei Modelle einzugrenzen, und prüfe diese Kandidaten an deinen eigenen Szenen.
Nein, der Spitzenreiter ist kein spezielles Modell für kreatives Schreiben
Der Name „Fable 5“ lud früher genau zu diesem Missverständnis ein. Dass nun Opus 5.5 ganz oben auf der Schreib-Bestenliste steht, legt eine andere Vermutung nahe: dass Anthropic sein empfohlenes Standardmodell gezielt auf literarische Prosa getrimmt hat. Die Dokumentation sagt etwas anderes.
Die Modellübersicht von Anthropic empfiehlt Claude Opus 5.5 für die meisten Aufgaben und verweist auf Claude Fable 5.1 für anspruchsvolles logisches Schließen und langlaufende Agenten-Workflows. Auf der Modellseite zu Opus 5.5 wird es als Modell für ausdauernde Agenten-Programmierung und Wissensarbeit beschrieben. Die Seite zu Fable 5.1 nennt stärkere Agenten-Programmierung, mehrstufige Recherche und Dokumentenarbeit zum selben Preis wie Fable 5. Kreatives Schreiben wird nirgendwo als offizieller Anwendungsfall aufgeführt.
Hersteller-Positionierung und tatsächliche Schreibleistung fallen weiterhin auseinander, nur auf andere Weise als noch im Sommer. Im August stand mit Fable 5 (veröffentlicht am 9. Juni 2026) das teuerste Modell an der Spitze. Im Oktober hält Opus 5.5 (veröffentlicht am 22. September 2026) den höchsten Punktwert – also genau das Modell, das Anthropic ohnehin als Einstieg empfiehlt, und das zu einem niedrigeren Preis als Fable und Opus 5. Das ist ein praktischer Zufall, aber eben ein Zufall. Fable 5.1 (veröffentlicht am 1. September 2026) ist laut Anthropic das leistungsstärkere Upgrade, schreibt auf dieser Bestenliste aber nicht besser als Fable 5.
Rohfassung, Überarbeitung und lange Manuskripte sind drei verschiedene Berufe
Wer „Schreiben“ als eine einzige Fähigkeit behandelt, greift fast zwangsläufig zum falschen Modell. In der Praxis sind es mindestens drei unterschiedliche Aufgaben.
Entwerfen (Drafting) belohnt Texte, die Menschen gerne lesen – genau das misst die LMArena. Für neue Prosa aus einer Skizze oder Gliederung weist die Bestenliste auf Opus 5.5 mit Effort high, während Fable 5 und Opus 4.6 auf high im selben Konfidenzintervall liegen. Wer Opus 5.5 nicht auf high stellt, nutzt nicht die Konfiguration, die 1516 Punkte erreicht hat.
Überarbeiten (Editing) verlangt eine andere Disziplin. Lektorat bedeutet, Vorgaben strikt einzuhalten: Tonfall bewahren, 15 % kürzen, Dialoge unangetastet lassen, Stilregeln anwenden. Das ist Anweisungstreue (instruction following), und hier ordnet LiveBench das Feld neu: Fable 5 auf max führt mit 75,8 vor Fable 5.1 (max, 73,0) und Opus 4.8 (max, 72,0). Opus 5.5 liegt mit 67,0 (xhigh) und 65,7 (max) hinter Opus 4.8, ist pro Token aber günstiger. Welches Modell „besser“ ist, hängt schlicht davon ab, welchen Auftrag du vergibst.
Lange Manuskripte hängen vom Kontextfenster und von der Stimmigkeit über viele Sitzungen ab – und genau hier enden die öffentlichen Messdaten. Die reine Kapazität ist dokumentiert: 1M Token, also rund 555.000 englische Wörter mit dem aktuellen Tokenizer von Opus 5.5, Fable 5.1 und Sonnet 5.5. Für die inhaltliche und stilistische Konsistenz gibt es dagegen keinen öffentlichen Benchmark. Kein Standardtest misst, ob die Erzählstimme über ein 60.000-Wörter-Projekt abdriftet, ob das Modell in Kapitel 20 das Sprachmuster einer Nebenfigur vergisst oder nach der vierzigsten Überarbeitung deinen Satzbau glattbügelt. Wir bauen derzeit eigene strukturierte Tests für genau diese Fragen auf und ergänzen diesen Artikel, sobald belastbare Messwerte vorliegen.
Was eine Schreibsitzung mit vier Durchgängen tatsächlich kostet
Die folgende Rechnung ist ein Rechenmodell auf Basis der offiziellen API-Preise von Anthropic, keine Einzelmessung. Damit lassen sich die Kostenverhältnisse realistisch vergleichen; deine eigenen Tokenzahlen werden je nach Arbeitsweise abweichen.
| Annahme | Wert |
|---|---|
| Generierungen pro Sitzung | 4 (ein Entwurf, drei Überarbeitungsrunden) |
| Eingabe pro Generierung | ~4.000 Token (Anweisungen, aktueller Entwurf, Notizen) |
| Ausgabe pro Generierung | ~1.400 Token |
| Summe pro Sitzung | 16.000 Token Eingabe, 5.600 Token Ausgabe |
Mit dem älteren Tokenizer entsprechen 1.400 Ausgabe-Token rund 1.050 englischen Wörtern, mit dem aktuellen Tokenizer eher 780 Wörtern. Bei den veröffentlichten Preisen pro Million Token ergibt sich:
| Modell | Erzeugte Wörter | Eingabekosten | Ausgabekosten | Kosten pro Sitzung |
|---|---|---|---|---|
| Claude Fable 5 und Fable 5.1 | ≈780 | $0,160 | $0,280 | $0,44 |
| Claude Opus 5, 4.8 und 4.7 | ≈780 | $0,080 | $0,140 | $0,22 |
| Claude Opus 5.5 | ≈780 | $0,064 | $0,112 | $0,18 |
| Claude Sonnet 4.6 | ≈1.050 | $0,048 | $0,084 | $0,13 |
| Claude Sonnet 5 und Sonnet 5.5 | ≈780 | $0,032 | $0,056 | $0,09 |
| Claude Haiku 4.5 | ≈1.050 | $0,016 | $0,028 | $0,04 |
Die Spalte „Erzeugte Wörter“ lässt sich nicht direkt über den Tokenizer-Wechsel hinweg vergleichen. Dieselben 5.600 Ausgabe-Token liefern mit dem älteren Tokenizer rund ein Drittel mehr Text. Opus 4.6 nutzt noch den alten Tokenizer und liefert zum selben Ausgabepreis ($5 / $25) rund 1.050 Wörter statt 780.
Zwei Faktoren verändern diese Rechnung in der Praxis. Erstens: Prompt Caching. Lesezugriffe aus dem Cache kosten bei den meisten dieser Modelle 10 % des regulären Eingabepreises, bei Opus 5.5 nur 5 % ($0,20 pro Million Token) und bei Fable 5.1 sogar nur 2,5 % ($0,25 pro Million Token); Fable 5 bleibt bei 10 % ($1 pro Million). Die schrittweise Arbeit an einem langen Manuskript eignet sich dafür ideal – allerdings nur für den Teil des Prompts, der unverändert am Anfang steht: System-Prompt, einmalig geladene Figuren- und Weltnotizen sowie der bisherige Gesprächsverlauf, an den nur angehängt wird. Wer einen umgeschriebenen Entwurf ganz oben im Prompt austauscht, macht das gecachte Präfix ungültig. Anthropics Batch-API halbiert die Kosten in beide Richtungen um 50 %, arbeitet aber asynchron und taugt nicht für das interaktive Schreiben. Die Preise von $1,50 und $7,50, die auf manchen Bestenlisten neben Sonnet 4.6 auftauchen, sind genau dieser Batch-Tarif, nicht der reguläre Preis von $3 und $15.
Der zweite Faktor wirkt in die Gegenrichtung: Thinking-Token werden als Ausgabe abgerechnet. Bei Fable 5.1 und Opus 5.5 ist das adaptive Nachdenken immer aktiv und lässt sich nicht abschalten; über den Parameter effort steuerst du, wie viel Denkaufwand du bezahlst. Ein kniffliges Strukturproblem erzeugt deutlich mehr Thinking-Token als eine einfache Stilkorrektur.
Die Effort-Einstellung: Der Hebel, den die meisten übersehen
In Anthropics Dokumentation zum Effort-Parameter steht ein Satz, der mehr Aufmerksamkeit verdient: Den Effort anzupassen ist oft wirkungsvoller, als das Modell zu wechseln. Effort ist ein Anfrage-Parameter; lässt du ihn weg, nutzt das Modell seine jeweilige Standardeinstellung.
Dieser Standard ist nicht mehr überall gleich. Opus 5.5 steht standardmäßig auf medium. Alle anderen aktuellen Modelle mit Effort-Unterstützung starten auf high. Haiku 4.5 unterstützt den Parameter nicht. Fable 5.1, Fable 5, Opus 5.5, Opus 5, Opus 4.8, Opus 4.7, Sonnet 5.5 und Sonnet 5 kennen fünf Stufen von low bis max. Opus 4.6 und Sonnet 4.6 unterstützen max, führen aber kein xhigh.
Beim Schreiben macht sich Effort unmittelbar bemerkbar: Höherer Effort kauft mehr Planung vor dem ersten Satz – klügere strukturelle Entscheidungen, sauberere Umsetzung langer Vorgaben und weniger vergessene Details. Dafür dauert die Antwort länger und kostet mehr Ausgabe-Token.
Für Opus 5.5 stammt der Spitzenwert auf der Schreib-Bestenliste aus der Zeile high, also eine Stufe über dem Standard medium. Wenn du dieses Niveau abrufen willst, musst du den Parameter aktiv hochsetzen. Geh nur für schnelle Wegwerf-Varianten auf low hinunter und schalte auf xhigh, wenn es um harte Strukturarbeit geht: ein Kapitel neu aufbauen, eine Szene reparieren, die immer wieder auseinanderfällt, oder ein Briefing mit vielen gleichzeitigen Einschränkungen umsetzen.
Bei Fable 5, Opus 4.7, Opus 4.8 und Sonnet 5 ist high bereits die Voreinstellung und entspricht direkt der Tabellenzeile. Bei Fable 5.1 (max) und Sonnet 5.5 (xhigh) liegen die veröffentlichten Benchmark-Werte jeweils über der Standardeinstellung high.
Ablehnungen, Tonfall und die Klage, Sonnet sei „kälter geworden“
Wenn Autorinnen und Autoren über ein Modell klagen, vermischen sich oft zwei verschiedene Dinge: dass das Modell eine Anfrage komplett ablehnt oder dass es sie zwar erfüllt, aber in einem spröden, leblosen Ton.
Was den Tonfall angeht, hält sich in der Community der Eindruck, Sonnet 5 lese sich trockener als Sonnet 4.5. Bemerkenswert ist, dass die Oktober-Bestenliste in dieselbe Richtung zeigt: Sonnet 5 auf high liegt mit 1435 zu 1454 genau 19 Punkte unter Sonnet 4.5, ohne Intervallüberlappung. Da Sonnet 4.5 am 30. November 2026 abgeschaltet wird, ist eine Rückkehr zu diesem Modell keine dauerhafte Lösung. Sonnet 4.6 bleibt jedoch erhalten und liegt ebenfalls knapp vor Sonnet 5.
Bei den Sicherheitsablehnungen (Refusals) ist die dokumentierte Lage breiter als noch im August. Laut Anthropic verfügen Claude Fable 5.1, Claude Fable 5, Claude Opus 5.5, Claude Opus 5 und Claude Sonnet 5.5 über Sicherheitsklassifikatoren, die Anfragen ablehnen können. Bei Opus 5.5 decken diese Klassifikatoren ein breiteres Spektrum ab als bei Opus 5. Darüber hinaus misst kein öffentlicher Benchmark die Ablehnungsquote bei literarischen Texten – jede Rangliste dazu wäre frei erfunden.
Was in der Praxis zuverlässig hilft, ist sauberer Kontext: Erkläre, dass du an einem fiktionalen Text arbeitest, und nenne Gattung, Genre sowie Zielgruppe. Beschreibe, welche Funktion eine schwierige Szene in der Handlung erfüllt – welchen Preis die Figur zahlt oder welchen Konflikt sie vorbereitet – und verlange nur den Detailgrad, den die Szene tatsächlich braucht. Das sind genau die Angaben, die auch ein menschliches Lektorat vor einem harten Kapitel kennen möchte.
Welches Claude-Modell für welchen Schreibtyp?
Budget zuerst. Sonnet 4.6 für $3 und $15 pro Million Token. Auf der Schreib-Bestenliste liegt es knapp vor Sonnet 5 ($2 und $10). Wenn die Rechnung wichtiger ist als dieser schmale Vorsprung, ist Sonnet 5 die günstigere, solide gemessene Option. Sonnet 5.5 kostet genauso viel wie Sonnet 5, lässt sich mit 658 Stimmen aber noch nicht sicher bewerten. Haiku 4.5 ist noch günstiger, landet beim kreativen Schreiben jedoch auf Rang 133.
Romanautorinnen, Romanautoren und lange Sachbücher. Opus 5.5 mit Effort auf high, wenn du die Konfiguration von der Bestenliste nutzen willst. Es schlägt Opus 4.7 auf high ohne Intervallüberlappung und kostet $4 und $20 statt $5 und $25. Plane beim Kontextfenster den neuen Tokenizer ein. Fable 5 ist das Upgrade, wenn du dem Wert aus 8.182 Stimmen mehr vertraust als den 1.058 Stimmen bei Opus 5.5 – zum Zweieinhalbfachen des Tokenpreises.
Tägliche Inhalte und hohes Textpensum. Sonnet 4.6 als Standard, während Opus 5.5 auf high für die wirklich wichtigen Texte reserviert bleibt. Bei rund $0,13 pro Sitzung fällt ein täglicher Entwurf über den Monat kaum ins Gewicht. Wichtiger als die Modellwahl ist ohnehin, wie gründlich du den Entwurf anschließend selbst überarbeitest. Wenn du einfach schnell einen ersten Rohentwurf brauchst, auf den du reagieren kannst, beschreib dein Vorhaben in unserem KI-Textgenerator und öffne den Entwurf direkt im Arbeitsbereich – ganz ohne API-Einrichtung.
Lektorat und Textüberarbeitung. Fable 5 wegen des klaren Vorsprungs beim Instruction Following auf LiveBench: 75,8 auf max gegenüber 65,7 (max) und 67,0 (xhigh) bei Opus 5.5. Soll das Budget auf Opus-Niveau bleiben, führt Opus 4.8 auf max mit 72,0 weiterhin vor Opus 5.5. Wenn deine Aufgabe darin besteht, ein Stylesheet durchzusetzen, den Tonfall stabil zu halten und exakt die gewünschten Kürzungen vorzunehmen, teste Opus 4.8 oder Fable 5 an einem Kapitel, das du in- und auswendig kennst.
Die größte Reibung im Schreiballtag entsteht ohnehin selten durch das Modell selbst. Sie entsteht, wenn der Entwurf im ersten Tab liegt, die Recherche im zweiten, die Gliederung im dritten und nirgendwo ein Versionsverlauf existiert. Genau dafür haben wir Muses gebaut: eine Schreibumgebung, in der Manuskript, Figurennotizen, Recherchematerial und KI-gestützte Überarbeitung in einem Projekt zusammenliegen – inklusive Versionshistorie, falls eine Überarbeitungsrunde in die falsche Richtung läuft. Die Plattform hält die eingebundenen Modelle aktuell, sodass du dich nicht selbst um API-Schlüssel und Parameter kümmern musst. Jetzt kostenlos ausprobieren.
Modell-Abschaltungen: So schützt du deinen Schreib-Workflow
Modellempfehlungen haben ein Verfallsdatum. Mehrere der oben genannten Favoriten gehören nicht zur allerneuesten Generation, und ein Modell aus unserer August-Auswertung hat inzwischen ein festes Abschaltdatum.
Sonnet 4.5 wurde am 30. September 2026 als veraltet markiert und wird am 30. November 2026 endgültig abgeschaltet. Als Nachfolger empfiehlt Anthropic claude-sonnet-5-5. Zwar liegt Sonnet 4.5 auf der Schreib-Bestenliste noch immer vor Sonnet 5, doch für neue Projekte solltest du nicht mehr darauf setzen.
Haiku 4.5 wird weiterhin als aktiv geführt. Die Deprecation-Übersicht nennt als frühestes Abschaltdatum den 15. Oktober 2026, führt aber noch keine Abkündigung auf. Da Anthropic für öffentliche Modelle mindestens 60 Tage Vorlauf vor einer Abschaltung garantiert, steht noch kein Termin fest. Das nächste früheste Datum unter den hier besprochenen Modellen hat Opus 4.5 (nicht vor dem 24. November 2026).
Alle übrigen Modelle haben deutlich mehr Spielraum: Sonnet 4.6 läuft mindestens bis zum 17. Februar 2027, Opus 4.6 bis zum 5. Februar 2027, Opus 4.7 bis zum 16. April 2027, Opus 4.8 bis zum 28. Mai 2027, Sonnet 5 bis zum 30. Juni 2027, Fable 5 bis zum 9. Juni 2027, Opus 5 bis zum 24. Juli 2027, Fable 5.1 bis zum 1. September 2027, Opus 5.5 bis zum 22. September 2027 und Sonnet 5.5 bis zum 28. September 2027. Das sind garantierte Mindestlaufzeiten („not sooner than“), keine Abschaltankündigungen.
Wenn du die API direkt ansprichst, hinterlege immer die exakte Modell-ID. Laut Anthropic verweist jede Claude-Modell-ID auf einen festen Snapshot – auch die datumsfreien IDs ab Generation 4.6. claude-opus-5-5 bezeichnet also dauerhaft exakt dasselbe Modell. Wie du die verschiedenen Werkzeugklassen im Schreiballtag kombinierst, erfährst du auch in unserer Dokumentation zur Auswahl deines KI-Tools.
Wie wir diesen Artikel aktuell halten
Zuletzt überprüft: 7. Oktober 2026.
Wir prüfen diese Übersicht monatlich in drei Punkten: Modellportfolio und IDs, veröffentlichte API-Preise sowie den aktuellen Stand der Benchmarks. Sobald sich Wertungen so verschieben, dass sich eine Empfehlung ändert, passen wir den Text und das Aktualisierungsdatum an. In der August-Fassung stand an dieser Stelle noch, das neueste Claude-Modell sei nicht das beste zum Schreiben. Mit dem Oktober-Snapshot gilt dieser Satz nicht mehr – also haben wir ihn korrigiert.
Verwendete öffentliche Quellen:
- LMArena-Leaderboard-Datensatz – Text-Arena, Untergruppe
style_control, Kategoriecreative_writing, Snapshot vom 2026-10-02. Bradley-Terry-Wertungen aus anonymen Paarvergleichen, auf ganze Zahlen gerundet. - LiveBench – Fragensatz 2026-06-25. Kategoriedurchschnitte für
languageundinstruction following, abgerufen am 7. Oktober 2026 inklusive der jeweiligen Effort-Stufe. - Anthropic Modellübersicht – Kontextfenster, Ausgabelimits, Preise, Thinking-Modi, Standard-Effort, Wissensstand und Tokenizer-Hinweise.
- Anthropic Preise – Preise pro Million Token, Prompt-Caching-Faktoren und Batch-API-Rabatt.
- Modellauswahl und Effort-Parameter – Effort-Stufen und Empfehlungen zur Steuerung des Denkaufwands.
- Ablehnungen und Fallbacks – Dokumentation der Sicherheitsklassifikatoren aktueller Modelle.
- Modell-Abschaltungen – Lebenszyklus-Status, Mindestlaufzeiten und Vorankündigungsfristen.
Wenn du tiefer in das handwerkliche Überarbeiten einsteigen willst statt in Modellparameter, zeigt dir unser Leitfaden Besser schreiben lernen den Zyklus aus Rohfassung, Abstand, Feedback und Überarbeitung, in den sich jedes dieser Modelle sinnvoll einfügt.
Häufige Fragen
Welches Claude-Modell eignet sich am besten zum Schreiben?
Claude Opus 5.5 erreicht mit der Einstellung high den höchsten Claude-Wert auf der stilbereinigten Bestenliste für kreatives Schreiben (1516), doch sein 95-%-Konfidenzintervall von 1497 bis 1536 überschneidet sich mit Fable 5 auf high (1503, Intervall 1495 bis 1510) und Opus 4.6 auf high (1501, Intervall 1494 bis 1507). Der Vorsprung ist noch nicht statistisch gesichert. Zudem ist high bei Opus 5.5 nicht die Standardeinstellung, sondern medium. Das neuere Fable 5.1 liegt auf max bei 1482 und damit unterhalb von Fable 5. Für Sonnet 5.5 gibt es noch zu wenige Stimmen.
Ist Claude Opus 5.5 oder Claude Sonnet 5.5 besser für lange Texte?
Nach den bisher vorliegenden Daten liegt Opus 5.5 vorn. Auf high erreicht es 1516 Punkte (Intervall 1497 bis 1536). Sonnet 5.5 ist bislang nur mit einer xhigh-Zeile vertreten (1447 Punkte, Intervall 1424 bis 1471 aus 658 Stimmen); die Intervalle überschneiden sich zwar nicht, doch 658 Stimmen reichen für ein belastbares Urteil noch nicht aus. Opus 5.5 kostet 4 und 20 US-Dollar pro Million Token gegenüber 2 und 10 US-Dollar bei Sonnet 5.5. Weder high bei Opus 5.5 (Standard ist medium) noch xhigh bei Sonnet 5.5 (Standard ist high) sind die Voreinstellung.
Welches Claude-Modell ist am besten für Belletristik und kreatives Schreiben?
Den höchsten Punktwert hält Claude Opus 5.5 auf high mit 1516 Punkten. Wenn du ein Ergebnis suchst, das sich auf deutlich mehr Stimmen stützt, erreicht Fable 5 auf high 1503 Punkte aus 8.182 Stimmen gegenüber 1.058 Stimmen bei Opus 5.5, wobei sich beide Intervalle überschneiden. Fable 5.1 auf max übernimmt diesen Platz nicht: Mit 1482 Punkten (Intervall 1469 bis 1494) bleibt es klar hinter Fable 5 zurück. Verzichte bei Belletristik auf Haiku 4.5, das auf Platz 133 landet.
Wurden Claude Opus 5.5 oder Fable 5 speziell für kreatives Schreiben entwickelt?
Nein. Anthropic positioniert Opus 5.5 für langlaufende Agenten-Programmierung und Wissensarbeit und empfiehlt es als Ausgangspunkt für die meisten Aufgaben. Fable 5.1 ist für anspruchsvolles logisches Schließen und komplexe Agenten-Aufgaben gedacht, genau wie zuvor Fable 5. Kreatives Schreiben gehört nicht zu den offiziellen Anwendungsfällen. Die hohen Bewertungen in den Schreib-Benchmarks sind ein reales Ergebnis aus Nutzerabstimmungen, aber keine Designabsicht.
Welches Claude-Modell sollte ich standardmäßig für alltägliche Texte nutzen?
Sonnet 4.6, wenn du einen mit genügend Stimmen abgesicherten Prosawert willst. Es kostet 3 und 15 US-Dollar pro Million Token und erreicht 1449 Punkte (Intervall 1443 bis 1456), knapp vor Sonnet 5 auf high (1435, Intervall 1428 bis 1442). Sonnet 5.5 ist das aktuelle und mit 2 und 10 US-Dollar günstigere Modell, hat beim kreativen Schreiben aber erst 658 Stimmen auf xhigh (Intervall 1424 bis 1471) und deckt damit beide älteren Werte ab.
Kann Claude ein ganzes Buch schreiben?
Es kann ein ganzes Buch im Speicher halten. Ein Kontextfenster von einer Million Token fasst mit dem aktuellen Tokenizer rund 555.000 englische Wörter, sodass ein kompletter Roman in eine einzige Sitzung passt. Ein gutes Buch in einem Durchgang zu generieren, gelingt jedoch keinem Modell. In der Praxis funktioniert die Arbeit Kapitel für Kapitel, während Gliederung und Stilprofil im Kontext bleiben und jedes Kapitel vor dem nächsten Schritt überarbeitet wird.
Wie bewahre ich meinen eigenen Schreibstil bei der Arbeit mit Claude?
Gib dem Modell deinen eigenen Text als Arbeitsgrundlage, statt es zu bitten, Prosa in deinem Stil frei zu erfinden. Füge zwei bis drei eigene Absätze ein, benenne deine stilistischen Regeln und bitte um Lektoratsnotizen oder Strukturvorschläge statt fertiger Kapitel. Schreib anschließend die Stellen in deinen eigenen Worten neu. Deine eigene Stimme überlebt die Überarbeitung zuverlässiger als die reine Textgenerierung.
Warum lehnt Claude manche Anfragen beim kreativen Schreiben ab, und welches Modell blockiert am seltensten?
Anthropic dokumentiert Sicherheitsklassifikatoren für Claude Fable 5.1, Claude Fable 5, Claude Opus 5.5, Claude Opus 5 und Claude Sonnet 5.5, die Anfragen ablehnen können. Das Ablehnungsverhalten unterscheidet sich zwischen den Modellen, doch kein öffentlicher Benchmark misst die Ablehnungsquote beim kreativen Schreiben. Praktisch hilft Kontext statt Umgehungsversuchen: Stell klar, dass es sich um Fiktion handelt, nenn Genre und Zielgruppe, erklär die dramatische Funktion der Szene im Buch und fordere nur den Detailgrad an, den der Text tatsächlich braucht.