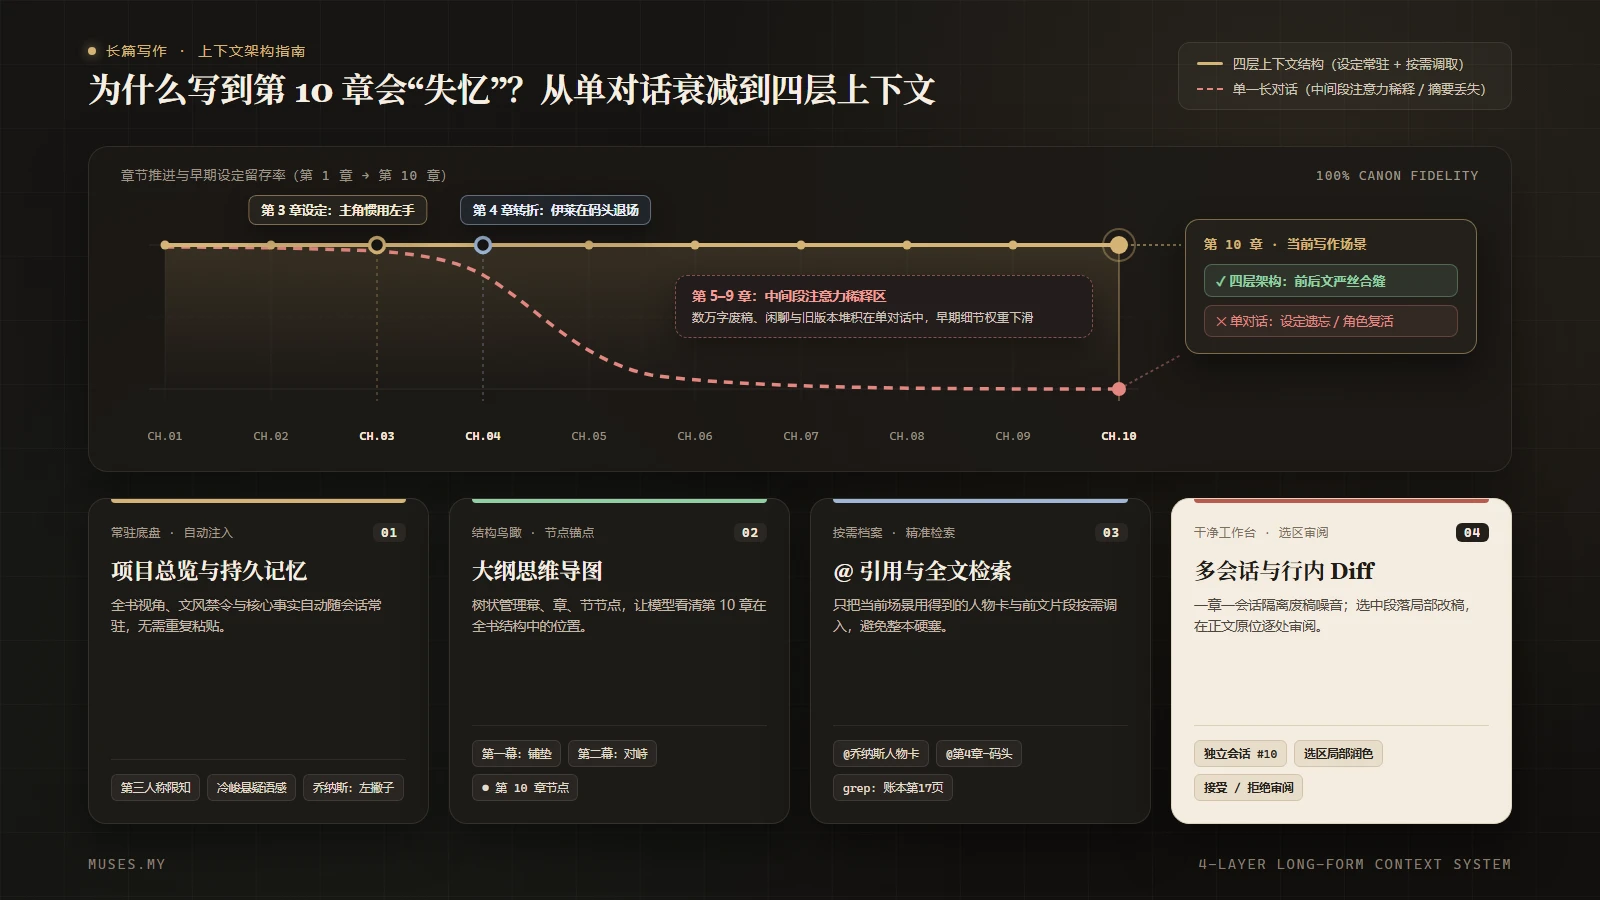
為什麼 AI 寫到第 10 章就開始“失憶”?長篇寫作的上下文管理指南
寫前幾章時 AI 什麼都記得,寫到第 10 章卻突然忘了主角是左撇子、已經退場的角色又開口說話。拆解長對話為什麼會丟細節,以及怎樣用四層上下文結構守住整本書的連續性。
寫前五章的時候,你覺得自己找到了完美的搭檔。AI 記得主角喬納斯說話簡短、習慣用左手,記得港口小鎮連下了三天雨,也記得線人伊萊在第 4 章末尾死在了碼頭。
寫到第 10 章,這個對話已經有七八十輪。你讓它起草一場廚房裡的對峙戲。幾秒鐘後內文出來了:喬納斯伸出右手去拿桌上的刀,瑪拉轉頭勸他「給伊萊打個電話核實一下貨單」。
你愣住了。在對話方塊裡糾正它:「喬納斯是左撇子,伊萊第 4 章就死了。」它馬上道歉,重來一版。可過了兩章,它又把瑪拉的妹妹寫成了她的堂姐。你忍無可忍,決定關掉這個變得又慢又亂的舊視窗,新開一個對話——結果面對空白的輸入框,你發現自己得先把一萬五千字的人物小傳、世界觀設定和前九章梗概重新挑出來粘進去,才能寫下第 10 章的第一句話。
幾乎每個用 ChatGPT 或 Claude 寫長篇的人,都在第 8 到第 12 章之間撞上過這堵牆。
透明說明: 我們開發 Muses,一個把 AI 聊天放進編輯器的寫作工作區。本文由團隊撰寫,文中關於產品的每一句,都對應當前真實可用的功能。
先說結論
- 「上下文視窗夠大」不等於「模型能記住全書」。 視窗是容量上限,不是注意力保證;對話越長,夾在中間的早期細節權重越低。
- 把整本書聊進同一個對話方塊,是在拿廢稿汙染定稿。 被你否掉的分支劇情、改了三次的半成品和最終內文混在一起,模型分不清哪句算數。
- 長篇不崩盤的核心,是把「檔案」和「工作臺」分開。 定稿章節、人物設定和大綱應該立在對話外面,對話只用來處理眼下這一幕。
- 上下文要按變化頻率分成四層。 全書總覽常駐、結構大綱指路、人物與前文按需調取、當前段落區域性精修。
- 當 AI 站在你的專案裡,你就不用靠複製貼上替它續命。 它能自己查前文、讀素材、看導圖、維護專案記憶,你只管推進故事。
為什麼對話越長,AI 越容易“吃設定”
很多人以為 AI 忘設定是因為「字數超了」。其實哪怕模型標稱支援幾十萬甚至上百萬 Token,只要你用一個無限拉長的聊天視窗寫長篇,穿幫依然會在第 10 章左右準時出現。背後有四個機制性的原因:
一、注意力在長文字里是「兩頭重、中間輕」的。 模型處理超長上下文時,對最開頭和最近幾輪的指令最敏感,而夾在第 15 輪到第 60 輪之間的細節——比如第 3 章順手提過的一句「他右手腕舊傷未愈,常年用左手」——在注意力分配裡會大幅衰減。除非你在當前這一輪再次提醒,否則模型很容易順著最常見的語言慣性,寫出「他伸出右手」。
二、聊天記錄裡混著太多「已經作廢的宇宙」。 寫長篇免不了試錯。你可能在第 4 章討論過「要不要讓伊萊假死脫身」,聊了五輪後決定還是讓他死透;你可能把第 7 章的結尾改了三版。但在同一個聊天執行緒裡,這三條分支、三個版本的文字全都留在上下文裡。模型看到的不是一份乾淨的定稿,而是一堆互相矛盾的施工現場。
三、滑動視窗和後臺壓縮會悄悄抹掉伏筆。 當單次對話長到一定程度,聊天工具為了控制成本與響應速度,往往會截斷早期訊息,或把前文壓縮成內部摘要。摘要擅長保留主幹(「第 4 章:碼頭衝突,主角拿到賬本」),卻極不擅長保留伏筆和道具細節(「賬本缺了第 17 頁」「懷錶停在三點一刻」)。被摘要吃掉的細節,後面自然接不上。
四、一旦另開新對話,上下文就徹底歸零。 為了擺脫舊視窗的汙染,你點下「新建對話」。這時候模型乾淨了,但也徹底失憶了。你不得不在幾十個文件和舊聊天記錄裡翻找設定,手工拼湊一份「前情提要」粘進新視窗——這就是長篇作者最頭疼的「上下文搬運工」困境。
不靠“一個超長對話方塊”:長篇上下文的四層結構
想讓 AI 在第 30 章依然像第 3 章那樣清醒,辦法不是找一個能塞進一百萬字的聊天框,而是別把所有資訊都平鋪在同一個層級裡。
一套抗衰減的長篇上下文,應該按「多長時間變一次」和「什麼時候用得上」,拆成四層:
| 層級 | 放什麼內容 | 更新頻率 | 什麼時候餵給 AI |
|---|---|---|---|
| 1. 常駐底盤(全書總覽與鐵律) | 敘事視角、文風禁區、核心主線、主要人物一句話定位、當前寫到哪 | 全書很少大改,階段推進時微調 | 每個新會話自動帶上,保持在 500–1,000 字以內 |
| 2. 結構鳥瞰(大綱與節拍表) | 分卷/分章大綱、人物關係網、關鍵伏筆埋設與回收節點 | 調整劇情走向時更新 | 規劃新章節、檢查節奏或核對前後因果時調取 |
| 3. 按需檔案(人物卡、世界觀與已定稿章節) | 詳細人物小傳、地點與專有名詞表、參考資料、前幾章定稿內文 | 隨寫作不斷沉澱 | 只在本場戲涉及該人物、地點或前文伏筆時精準調取 |
| 4. 當前工作臺(本場戲與區域性選區) | 正在寫的這一章、當前選中的一兩段話、針對這一幕的具體修改指令 | 每幾分鐘都在變 | 在乾淨的短期會話裡處理,改完落回內文 |
這個結構解決了一個根本矛盾:AI 既需要知道全書的規矩(第 1 層),又需要查具體某個人物的細節(第 3 層),同時還不能被無關章節的幾萬字廢話干擾當前這一段的文風(第 4 層)。
在 Muses 裡,這四層上下文是怎麼運轉的
如果用「文件編輯器 + 外部聊天視窗」,上面這四層結構得靠你自己建資料夾、手動複製貼上來維護。而在 Muses 裡,這四層本身就是工作區的原生結構:左邊是專案與素材,中間是內文或心智圖,右邊是 AI 聊天。
第一層:分層的持久記憶(使用者記憶 + 專案總覽 + 專案明細)
Muses 的持久記憶不是把舊聊天記錄胡亂塞進提示詞,而是整理成結構化的三部分:
- 使用者記憶(User Memory):跨專案生效的長期習慣,比如你偏好的冷峻敘事語感、標點習慣、不喜歡的形容詞套路。
- 專案總覽(Project Overview):當前這本書的常駐底盤——核心梗概、敘事視角、主要人物關係、寫作規則和整體進度。
- 專案明細(Project Details):專案內按主題拆開的獨立筆記(比如某條支線的時間線、某個陣營的規則),還可以關聯到專案裡的具體文章或素材,隨著故事推進建立、修訂或歸檔。
每次你在專案裡開啟一個新對話,使用者記憶和專案總覽會自動注入首輪上下文,不需要你重貼一遍設定;到了具體場景,AI 可以用搜尋工具(grep)或記憶工具(memory)按需讀取、更新相關的專案明細。編輯器的自動補全與聽寫同樣會讀取使用者記憶、專案總覽以及關聯到當前文件的活動明細。
你想核對 AI 到底記住了什麼時,在編輯器裡開啟 「檢視記憶」 就能一目瞭然地瀏覽使用者記憶、專案總覽和活動明細;發現哪裡設定改了,直接在聊天裡交代一句,或者切換到 「更新記憶」 工作模式,讓 AI 對照專案內容把記憶梳理乾淨。
第二層與第三層:同專案內的文章、素材與心智圖,隨用隨調
在同一個專案裡,你的章節內文(文章)、人物小傳與世界觀設定(素材庫文章、txt / md / docx 文件、PDF、網頁連結、圖片)以及大綱(心智圖)都在同一個邊界內:
- 用
@點名本場戲要用的檔案。 寫第 10 章喬納斯和瑪拉的爭執時,不用去翻資料夾複製貼上,直接在聊天輸入框裡打@(支援半形@與全形@),選中《喬納斯人物卡》和《第 4 章:碼頭》,每條訊息最多可以同時引用 5 份專案內的文章或素材。 - 讓 AI 自己去查前文。 記不清第 3 章某把鑰匙放在哪、或者某個配角叫什麼名字?直接讓 AI 在專案裡搜。它的
grep工具能同時檢索當前專案的已儲存文章、素材(含素材文章、文字、網址、PDF 摘要及心智圖節點主題)和記憶,再用read工具按塊或按行讀取原文。 - 心智圖與內文互通。 AI 能直接讀取專案裡的心智圖大綱;當你調整了章節結構,它對已有導圖的修改會在畫布上逐節點標出,等你逐項確認後再寫入。
第四層:多會話工作臺 + 選區改稿 + 行內審閱
為了不讓一個對話方塊被七八十輪討論撐爆,Muses 在網頁端和桌面端都預設提供多會話工作臺:
- 不同任務分標籤頁聊,互不汙染。 當你開啟第二個會話時,聊天面板頂部會出現會話標籤頁、新建按鈕和歷史入口。你可以留一個會話專門推演第 11–15 章的大綱,再新建一個乾淨的會話專門精修第 10 章的對白——那些被否掉的腦暴分支永遠不會混進改稿會話裡。
- 選中哪段改哪段,改動落在原文上等審閱。 在內文裡選中要改的三段話,選區會自動附在訊息上方發給 AI。AI 對已有文章的修改不會直接覆蓋你的定稿,而是在原句上用刪除線和標記做行內對比:如果它把「左手」寫成了「右手」,你一眼就能看見並直接點「拒絕」,只把寫得好的那幾句點「接受」收進內文;接受之後還能一鍵撤銷最近一次接受的修改(只要還沒繼續編輯內文)。桌面端使用本地專案時,登入並聯網後也是完全相同的並排聊天、專案檢索與行內審閱流程。
如果你還在普通聊天視窗裡寫,今天就能改的四個習慣
即使你現在仍然在 ChatGPT 或 Claude 的網頁端寫長篇,只要改掉「一個視窗聊到底」的習慣,今天就能把第 10 章的失憶率降下來:
一、永遠不要把聊天記錄當成“定稿真源”
聊天視窗只是草稿紙,編輯器裡的文件才是唯一算數的地方。一旦某段劇情在聊天裡定下來,立刻粘回你的內文或設定集,並把設定集裡的舊說法改掉——不要指望 AI 自己從四十輪對話裡推斷出你最後選了哪個方案。
二、每寫完一章,維護一張 150 字的“章節交接卡”
不要把前九章的幾萬字原文全塞給第 10 章的對話,也不要只寫一句籠統的「第 9 章:兩人吵了一架」。每章定稿後,花兩分鐘記一張只寫狀態變化的交接卡:
【第 9 章交接卡】
- 時間與地點:週四深夜 23:40,老港區喬納斯公寓廚房(窗外剛停雨)
- 在場人物狀態:喬納斯(右手腕舊傷,慣用左手,剛從碼頭回來,外套溼透);瑪拉(已知曉賬本缺頁,站在窗邊背對他)
- 已不可逆的事實:線人伊萊已於第 4 章碼頭身亡;賬本第 17 頁在瑪拉口袋裡,喬納斯還不知道
- 本章留下的鉤子:樓下駛過一輛熄燈的灰車,瑪拉正在數秒等喬納斯先開口
這張卡片只有一百多字,卻把第 10 章最容易穿幫的物理位置、生理特徵、生死狀態和資訊差全部鎖死了。
三、一章一開新會話,只帶“本場戲進門的人和事”
每寫新的一章(甚至新的一個大場景),果斷開啟一個新對話。首條訊息只放三樣東西:
- 全書常駐底盤(文風規則 + 核心背景,500 字以內);
- 本場戲出場人物的人物卡片段(不整本全貼,第 10 章只有喬納斯和瑪拉,就不貼反派和配角);
- 上一章的 150 字交接卡 + 本章要完成的 3 個情節拍子。
上下文越乾淨、越聚焦,模型的注意力就越集中,寫出來的動作和對白也越貼合人物。
四、一旦發現 AI 穿幫,改檔案重發,別在對話裡跟它吵
當 AI 寫出「喬納斯伸出右手」或讓死人復活時,很多人的第一反應是在下面回一句:「不對!他是左撇子,重來!」
這樣糾正一次可以,但如果連著糾正兩三次,整個對話就會被錯誤資訊和道歉刷屏,反而強化了錯誤詞條在上下文裡的存在感。更乾淨的做法是:把漏掉的約束補進你那條輸入提示詞裡,直接編輯上一條訊息重新生成,讓錯誤的分支從一開始就不留在對話歷史裡。
寫在最後
AI 寫到第 10 章開始“失憶”,不是因為它突然變笨了,而是因為對話視窗本就不是用來存一本書的。把設定、廢稿、大綱和十幾個章節全堆在一條時間線裡,任何模型都會被噪音淹沒。
把上下文按「常駐底盤、結構大綱、按需檔案、當前工作臺」分成四層,你的長篇就有了骨架:該永遠記住的留在總覽和記憶裡,該查證的放在素材和前文裡按需調取,該專注打磨的留在乾淨的當前會話與行內審閱裡。
Muses 就是圍繞這套工作流搭建的:使用者記憶、專案總覽與專案明細分層維護,文章、素材和心智圖同處一個專案邊界,用 @ 引用或讓 AI 直接檢索前文,多會話標籤頁把推演大綱和精修章節隔開,所有對已有內文的修改都落在原句上等你逐條確認。想把正在寫的長篇搬進來試試,可以新建一個專案,或者先看看小說寫作工作區和AI 小說寫作工具是怎麼配合長篇創作的。如果你也在被視窗切換和格式丟失困擾,可以接著讀複製貼上稅:在 ChatGPT 和 Claude 裡寫作,你到底多付了什麼與如何用 AI 寫一本書:八步流程。
開始是免費的:免費版包含預設的 Clio 模型和每月 50,000 星力值;付費方案按訂閱計費,具體價格以結算頁為準。免費開始。
常見問題
為什麼模型的上下文視窗很大,寫長篇還是會忘設定?
上下文視窗代表模型單次能接收的最大文字量,不代表它對視窗內每個位置的注意力一樣強。當同一個對話裡塞滿幾十輪廢稿、討論和內文時,夾在中間的早期細節很容易被近期的對話稀釋,或者在長對話壓縮時被略掉。
寫長篇應該一直留在同一個聊天視窗裡嗎?
不建議。同一個對話拖得越長,被否掉的構思和舊版本就越多,模型越難分清哪句是最終定稿。更穩妥的做法是把設定、大綱和成稿儲存在對話之外,按章節或按任務開啟乾淨的會話。
每次開新對話都要把前幾章和人物卡重新貼一遍嗎?
在普通聊天視窗裡往往需要手動挑材料貼上;但如果 AI 就在你的寫作專案裡工作,它可以自己檢索和讀取專案裡的章節、素材、心智圖與持久記憶,你只需要用 @ 點名本場用到的資料。
Muses 的記憶功能是怎麼存長篇背景的?
Muses 的持久記憶分為跨專案的使用者記憶、當前專案的專案總覽,以及按主題拆分的專案明細。每次開啟新對話時,使用者記憶和專案總覽會自動注入;對話過程中,AI 可以按需檢索、讀取和更新專案明細。
我能看到 AI 記住了哪些設定嗎?
能。在編輯器裡開啟「檢視記憶」就能看到使用者記憶、專案總覽和全部活動明細;需要補充或修正時,直接在聊天裡告訴 AI,或切到「更新記憶」工作模式讓它統一梳理。
在 Muses 裡可以同時開多個對話分別聊大綱和改內文嗎?
可以。網頁端和桌面端的聊天面板支援同專案多會話標籤頁,你可以留一個會話推演世界觀或大綱,再開一個新會話專門精修當前章節,兩邊互不串味。
免費版能用專案檢索、@ 引用和持久記憶嗎?
能。免費版包含預設的 Clio 模型和每月 50,000 星力值,專案內的文章、素材、心智圖、@ 引用與持久記憶均可使用;高階模型、語音與圖片生成另有額度或套餐檔位限制。