Meilleur modèle Claude pour écrire (2026) : Opus 5.5 prend la tête, mais l'écart reste ouvert
Opus 5.5 obtient le meilleur score Claude en écriture créative, sans creuser un écart définitif sur Fable 5 et Opus 4.6. Nos choix pour le premier jet, la révision et l'écriture quotidienne, avec les tarifs.
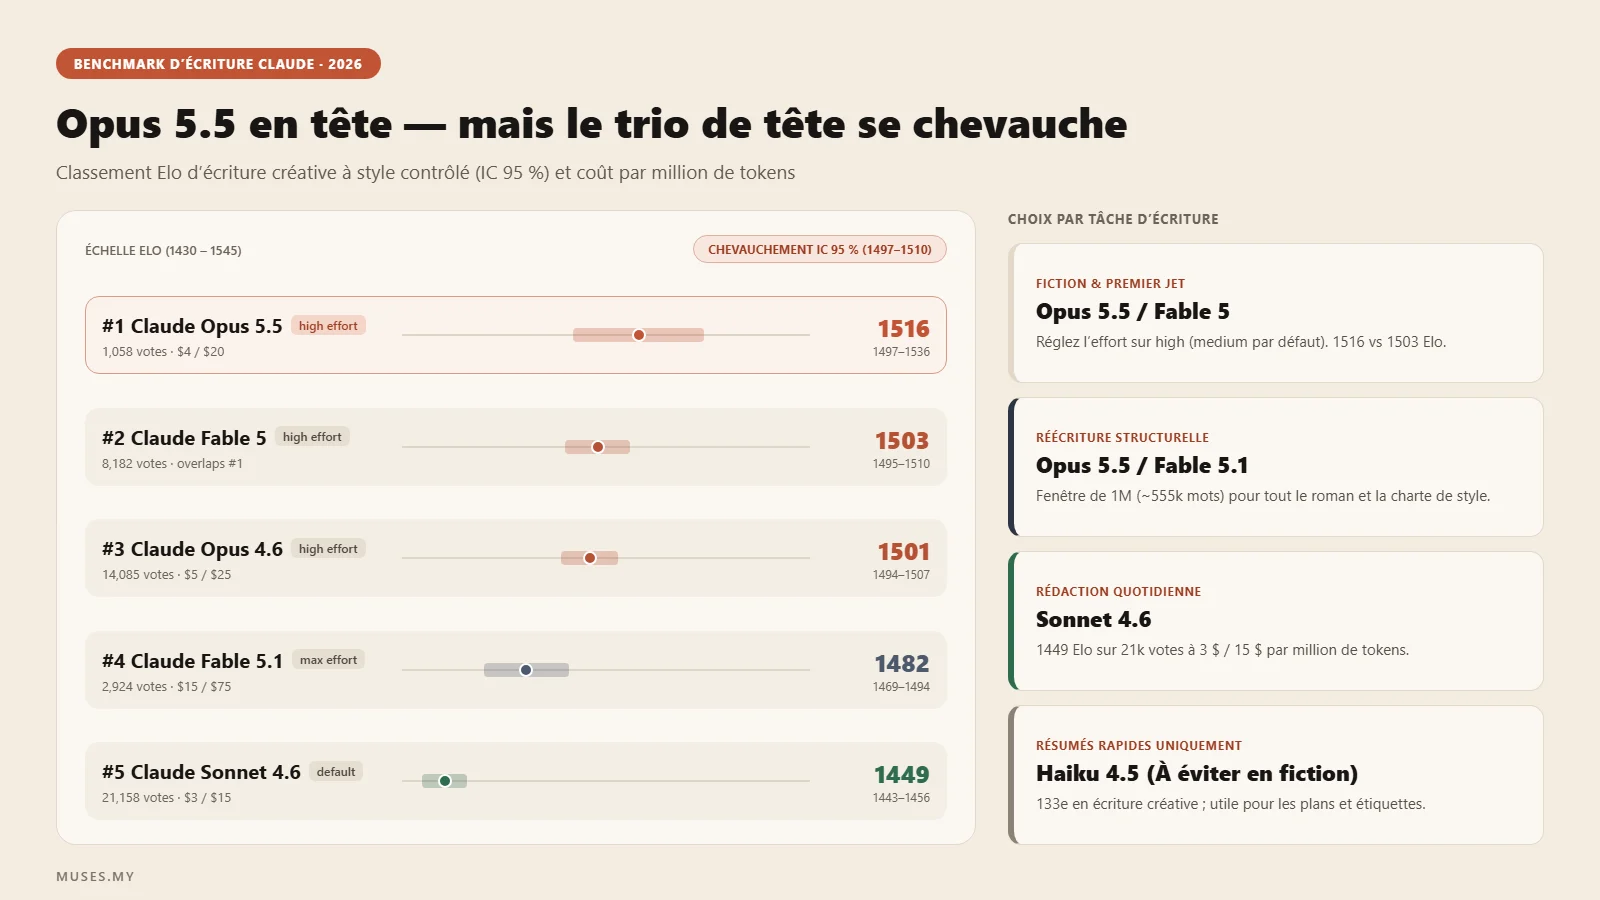
En bref, avant d'entrer dans les tableaux : le dernier Opus obtient le meilleur score Claude en écriture créative, mais son avance n'est pas encore verrouillée. Sur le classement d'écriture créative avec contrôle du style de LMArena (instantané du 2 octobre 2026), Claude Opus 5.5 réglé sur l'effort high atteint 1516. Son intervalle de confiance chevauche toutefois Claude Fable 5 (high) et Claude Opus 4.6 (high), et la ligne d'Opus 5.5 repose sur 1 058 votes contre 8 182 et 14 085 pour les deux autres. Le Fable le plus récent, Fable 5.1, fait moins bien que Fable 5. Le Sonnet le plus récent, Sonnet 5.5, ne réunit pas encore assez de votes pour trancher.
Rien de tout cela ne se devine au simple nom des modèles. La recommandation actuelle d'Anthropic consiste à démarrer avec Opus 5.5 pour la plupart des charges de travail, puis à passer à Fable 5.1 lorsque les tâches de raisonnement ardues résistent encore. Les cas d'usage officiels couvrent le codage agentique, le travail de connaissance et les projets au long cours. L'écriture créative n'en fait pas partie. C'est pourtant là que se sont portés les votes des lecteurs.
Nous développons Muses, un espace d'écriture intégrant l'IA, et nous suivons en continu les modèles de pointe parce que la tenue d'un brouillon dépend directement du modèle placé derrière le curseur. Tout ce qui suit provient de sources publiques : le jeu de données du classement LMArena, LiveBench et la documentation officielle d'Anthropic. Là où les données publiques s'arrêtent — sur la cohérence d'un manuscrit au long cours et sur le taux de refus par modèle —, cet article le signale clairement au lieu de combler le vide par des suppositions.
Réponse rapide : quel modèle Claude choisir pour écrire ?
| Votre tâche | Par où commencer | Prix / MTok (entrée / sortie) | Pourquoi |
|---|---|---|---|
| Premier jet de fiction et prose créative | Claude Opus 5.5, effort high | $4 / $20 | Meilleure estimation ponctuelle parmi les modèles Claude sur le tableau d'écriture créative avec contrôle du style. L'intervalle chevauche Fable 5 et Opus 4.6 en high, et high se situe un cran au-dessus du réglage par défaut d'Opus 5.5 |
| La même tâche, avec davantage de votes sous le score | Claude Fable 5, effort high | $10 / $50 | 1503 points sur 8 182 votes, dans la même fourchette statistique qu'Opus 5.5. Fable 5.1 ne reprend pas cette place |
| Manuscrits au long cours | Claude Opus 5.5, effort high | $4 / $20 | Devance nettement Opus 4.7 en high sans chevauchement d'intervalle et coûte moins cher que l'ancien tarif Opus ($5 / $25). Le nouveau tokeniseur réduit toutefois le volume de texte qui tient dans la fenêtre par rapport à Opus 4.6 |
| Révision selon une feuille de style | Claude Fable 5, ou Opus 4.8 au tarif Opus | $10 / $50, ou $5 / $25 | Suivi d'instructions sur LiveBench, effort max : Fable 5 à 75,8, Fable 5.1 à 73,0, Opus 4.8 à 72,0. Opus 5.5 en max descend à 65,7 |
| Rédaction quotidienne à budget maîtrisé | Claude Sonnet 4.6 | $3 / $15 | Assez de votes pour être lisible. Juste devant Sonnet 5. Sonnet 5.5, le modèle actuel, ne compte que 658 votes et ne peut pas encore être situé |
| Gros volumes à faible enjeu stylistique | Claude Haiku 4.5 | $1 / $5 | Environ quatre centimes de dollar par session de rédaction, 133e du classement d'écriture créative, avec la date plancher de retrait la plus proche |
S'il ne fallait retenir qu'une phrase : en octobre 2026, le meilleur Claude pour un premier jet est Opus 5.5 avec l'effort réglé sur high, Fable 5 si vous préférez vous fier à un score consolidé par des milliers de votes supplémentaires, Opus 4.8 lorsqu'il s'agit de réviser un texte au tarif Opus, et Sonnet 4.6 pour écrire tous les jours. Mettez cette sélection à l'épreuve sur vos propres pages : elle ne suit ni l'ordre de sortie des modèles, ni le réflexe « prenez toujours le plus récent ».
La gamme Claude 2026 pour les auteurs
Voici la famille actuelle, telle que présentée dans la vue d'ensemble des modèles d'Anthropic. En cas d'hésitation, Anthropic conseille de commencer par Opus 5.5 et de passer à Fable 5.1 lorsque vos propres essais à effort élevé sur Opus 5.5 ne suffisent plus.
| Modèle | Contexte | Sortie max. | Prix par MTok (entrée / sortie) | Réflexion (Thinking) | Effort par défaut | Coupure de connaissances fiable |
|---|---|---|---|---|---|---|
| Claude Fable 5.1 | 1M | 128K | $10 / $50 | Adaptatif, toujours actif | high | juin 2026 |
| Claude Opus 5.5 | 1M | 128K | $4 / $20 | Adaptatif, toujours actif | medium | juin 2026 |
| Claude Sonnet 5.5 | 1M | 128K | $2 / $10 | Adaptatif | high | juin 2026 |
| Claude Haiku 4.5 | 200K | 64K | $1 / $5 | Étendu | Non pris en charge | févr. 2025 |
Restent disponibles via l'API, mais classés par Anthropic dans la catégorie « Legacy » (anciennes générations) : Fable 5, Opus 5, Opus 4.8, 4.7, 4.6 et 4.5, Sonnet 5 et Sonnet 4.6. Opus 5 et les versions Opus 4.8 à 4.5 sont facturés $5 et $25, soit plus cher qu'Opus 5.5. Fable 5 partage le tarif de Fable 5.1 ($10 et $50). Sonnet 5 partage celui de Sonnet 5.5 ($2 et $10). Sonnet 4.6 reste affiché à $3 et $15, soit davantage que le nouveau Sonnet. Sonnet 4.5 quitte la sélection : déclaré obsolète le 30 septembre 2026, il répond encore aux appels API mais sera retiré le 30 novembre.
Un détail technique compte avant de mesurer votre manuscrit à l'aune de la fenêtre de contexte : Anthropic a changé de tokeniseur à partir d'Opus 4.7. Avec le tokeniseur actuel, un million de tokens correspond à environ 555 000 mots anglais ; avec l'ancien, le même million en accueillait près de 750 000. La documentation tarifaire d'Anthropic évalue l'augmentation à environ 30 % de tokens supplémentaires pour un texte identique. Fable 5.1, Opus 5.5, Sonnet 5.5, Fable 5, Opus 5, Sonnet 5, Opus 4.8 et Opus 4.7 utilisent le nouveau tokeniseur. Sonnet 4.6, Opus 4.6, Sonnet 4.5 et Haiku 4.5 conservent l'ancien. Une fenêtre de 1M sur Opus 5.5 contient donc sensiblement moins de chapitres de votre roman qu'une fenêtre de 1M sur Opus 4.6.
Ce que montre réellement le classement avec contrôle du style
LMArena recueille des votes anonymes de préférence humaine par paires et ajuste un score Bradley-Terry. Le contrôle du style (style_control) neutralise les biais de présentation qui font gagner des duel sans améliorer la prose, comme la longueur excessive ou l'abondance de titres et de listes à puces. Les chiffres ci-dessous sont extraits du sous-ensemble style_control de l'arène texte, catégorie creative_writing, dans le jeu de données public de LMArena daté du 2 octobre 2026, arrondis à l'entier le plus proche.
| Modèle | Variante dans l'arène | Score | Rang | IC 95 % | Votes |
|---|---|---|---|---|---|
| Claude Opus 5.5 | claude-opus-5.5-high | 1516 | 2 | 1497–1536 | 1 058 |
| Claude Fable 5 | claude-fable-5-high | 1503 | 3 | 1495–1510 | 8 182 |
| Claude Opus 4.6 | claude-opus-4-6-high | 1501 | 4 | 1494–1507 | 14 085 |
| Claude Opus 4.7 | claude-opus-4-7-high | 1489 | 6 | 1482–1496 | 11 812 |
| Claude Fable 5.1 | claude-fable-5.1-max | 1482 | 10 | 1469–1494 | 2 645 |
| Claude Opus 5 | claude-opus-5-high | 1471 | 13 | 1465–1478 | 13 263 |
| Claude Opus 4.8 | claude-opus-4-8-high | 1470 | 17 | 1463–1476 | 12 798 |
| Claude Sonnet 4.5 | claude-sonnet-4-5-20250929 | 1454 | 33 | 1448–1460 | 12 367 |
| Claude Sonnet 4.6 | claude-sonnet-4-6 | 1449 | 38 | 1443–1456 | 12 339 |
| Claude Sonnet 5.5 | claude-sonnet-5.5-xhigh | 1447 | 42 | 1424–1471 | 658 |
| Claude Sonnet 5 | claude-sonnet-5-high | 1435 | 65 | 1428–1442 | 9 413 |
| Claude Haiku 4.5 | claude-haiku-4-5-20251001 | 1388 | 133 | 1383–1393 | 24 158 |
Les suffixes d'effort dans la deuxième colonne déterminent si la ligne correspond à ce que vous allez réellement exécuter.
La ligne d'Opus 5.5 est en high, alors que son réglage par défaut dans l'API est medium. Omettre le paramètre ne reproduit donc pas ce score. Fable 5, Opus 4.6, Opus 4.7, Opus 4.8 et Sonnet 5 figurent en high, qui est bien leur valeur par défaut. Fable 5.1 n'apparaît qu'en max, un cran au-dessus de son high par défaut. Sonnet 5.5 n'apparaît qu'en xhigh, au-dessus de son high par défaut, avec 658 votes. Sonnet 4.6, Sonnet 4.5 et Haiku 4.5 n'ont pas de suffixe d'effort ; Haiku 4.5 ne prend pas du tout en charge ce paramètre.
La première place d'Opus 5.5 parmi les modèles Claude est une estimation ponctuelle, pas une échappée. L'intervalle 1497–1536 chevauche Fable 5 (1495–1510) et Opus 4.6 en high (1494–1507). En revanche, il dépasse nettement Opus 4.7 en high (1482–1496) sans chevauchement d'intervalle. Et Claude n'est pas seul au sommet : Gemini 4 Argon en effort high atteint 1519 (1er rang, intervalle 1499–1538), un intervalle qui chevauche lui aussi celui d'Opus 5.5.
Fable 5.1 n'hérite pas de la place de Fable 5. La seule ligne publiée est en effort max (1469–1494), tandis que Fable 5 en high se situe entre 1495 et 1510. Les deux intervalles ne se touchent pas — à rebours de ce que laisserait penser un modèle plus récent poussé à l'effort maximal.
Du côté des Sonnet, Sonnet 4.5 à 1454 (1448–1460) devance toujours Sonnet 5 en high à 1435 (1428–1442), mais il sera retiré le 30 novembre 2026. Sonnet 4.6 à 1449 (1443–1456) reste lui aussi devant Sonnet 5, à un point près aux bornes (1443 contre 1442). Quant à l'intervalle de Sonnet 5.5 (1424–1471), il recouvre à la fois Sonnet 4.6, Sonnet 5 et Sonnet 4.5 : 658 votes ne suffisent pas à les départager.
Parmi les modèles toujours facturés $5 et $25, Opus 4.7 en high (1482–1496) conserve son avance sur Opus 4.8 en high (1463–1476) sans chevauchement, tout comme sur les lignes sans suffixe -high (1483, intervalle 1476–1490, contre 1463, intervalle 1457–1470). Opus 5.5 en high devance Opus 4.7 en high tout en coûtant moins cher.
Les votes de préférence ne forment toutefois qu'un axe. LiveBench (jeu de questions 2026-06-25, relevé le 7 octobre 2026) évalue séparément la maîtrise de la langue (language) et le suivi d'instructions (instruction following), avec un classement très différent.
En langue, Fable 5 en effort max mène les lignes Claude à 90,7, suivi de Fable 5.1 (max) à 89,5, d'Opus 5 (max) à 88,7 et d'Opus 5.5 (max) à 86,3. Le dernier Opus n'est donc pas en tête sur cet axe et recule derrière l'Opus qu'il remplace.
En suivi d'instructions, l'ordre est complètement rebattu. Gemini 3.8 Flash (high) domine la liste publiée à 81,4. Le premier Claude est Fable 5 (max) à 75,8, puis Fable 5.1 (max) à 73,0, puis Opus 4.8 (max) à 72,0. Opus 5.5 plafonne à 67,0 en xhigh et 65,7 en max. Opus 4.7 (xhigh) est à 66,7, Opus 5 (max) à 63,8. Sonnet 5.5 passe de 70,5 en xhigh à 56,8 en max : un écart important qui rappelle qu'aucun chiffre unique ne résume la capacité à « bien écrire ».
Non, le modèle en tête du classement n'est pas un modèle d'écriture créative
Le nom de Fable 5 prêtait autrefois à cette confusion. La présence d'Opus 5.5 en haut du tableau d'écriture en suggère une autre : que le modèle recommandé par défaut par Anthropic aurait été réglé pour la prose littéraire. La documentation dit le contraire.
La vue d'ensemble des modèles invite à démarrer avec Claude Opus 5.5 pour la majorité des charges et à réserver Claude Fable 5.1 au raisonnement exigeant et au travail agentique à long horizon. La fiche d'Opus 5.5 le décrit comme bâti pour le codage agentique de longue haleine et le travail de connaissance. La fiche de Fable 5.1 met en avant le codage agentique, la recherche en plusieurs étapes et le traitement documentaire, aux mêmes tarifs d'entrée et de sortie que Fable 5. L'écriture créative n'apparaît dans aucun de ces descriptifs.
Positionnement et résultats continuent de diverger. En août, le modèle en tête du classement d'écriture était le modèle généraliste le plus coûteux, Fable 5 (sorti le 9 juin 2026). En octobre, la meilleure estimation ponctuelle revient au modèle qu'Anthropic conseille déjà par défaut, Opus 5.5 (sorti le 22 septembre 2026), à un tarif inférieur à Fable comme à Opus 5. C'est une heureuse coïncidence, mais cela reste une coïncidence.
Premier jet, révision et manuscrit long sont trois métiers distincts
Considérer « l'écriture » comme une compétence unique conduit à de mauvais choix de modèles. Il faut distinguer au moins trois tâches.
Rédiger un premier jet récompense ce que les lecteurs préfèrent lire, exactement ce que mesure l'arène. Pour produire de la prose neuve à partir d'une consigne ou d'un plan, le tableau d'écriture créative désigne Opus 5.5 en effort high, avec Fable 5 et Opus 4.6 en high dans le même intervalle. Si vous ne réglez pas Opus 5.5 sur high, vous n'exécutez pas la configuration qui a obtenu 1516.
Réviser et éditer fait appel à une tout autre compétence : suivre des consignes à la lettre (garder la voix, couper 15 %, ne pas toucher aux dialogues, appliquer une feuille de style). C'est du suivi d'instructions, où LiveBench place Fable 5 en effort max en tête des Claude (75,8), devant Fable 5.1 (max, 73,0) et Opus 4.8 (max, 72,0), tandis qu'Opus 5.5 reste à 67,0 (xhigh) et 65,7 (max).
Tenir un manuscrit long dépend de la fenêtre de contexte et de la constance d'une session à l'autre — là où les données publiques s'arrêtent. La capacité brute est connue : 1M de tokens, soit environ 555 000 mots anglais sur le tokeniseur actuel utilisé par Opus 5.5, Fable 5.1 et Sonnet 5.5. En revanche, aucun banc d'essai public ne mesure si la voix d'un modèle dérive au fil d'un projet de 60 000 mots, s'il oublie les tics de langage d'un personnage au chapitre 20 ou s'il lisse silencieusement votre syntaxe après la quarantième passe de révision. Nous construisons nos propres protocoles de test sur ce point et publierons les résultats dès qu'ils seront consolidés.
Ce que coûte réellement une session de rédaction en quatre tours
Le tableau suivant applique les tarifs publics d'Anthropic à un profil de session réaliste afin de rendre visibles les écarts de coût.
| Hypothèse | Valeur |
|---|---|
| Générations par session | 4 (un premier jet, trois passes de révision) |
| Entrée par génération | ~4 000 tokens (consignes, brouillon en cours, notes) |
| Sortie par génération | ~1 400 tokens |
| Total de la session | 16 000 tokens en entrée, 5 600 en sortie |
Sur l'ancien tokeniseur, 1 400 tokens de sortie représentent environ 1 050 mots anglais ; sur le nouveau, plutôt 780. Aux tarifs publiés par million de tokens :
| Modèle | Mots produits | Coût d'entrée | Coût de sortie | Coût par session |
|---|---|---|---|---|
| Claude Fable 5 et Fable 5.1 | ≈780 | $0,160 | $0,280 | $0,44 |
| Claude Opus 5, 4.8 et 4.7 | ≈780 | $0,080 | $0,140 | $0,22 |
| Claude Opus 5.5 | ≈780 | $0,064 | $0,112 | $0,18 |
| Claude Sonnet 4.6 | ≈1 050 | $0,048 | $0,084 | $0,13 |
| Claude Sonnet 5 et Sonnet 5.5 | ≈780 | $0,032 | $0,056 | $0,09 |
| Claude Haiku 4.5 | ≈1 050 | $0,016 | $0,028 | $0,04 |
La colonne des mots produits ne se compare pas directement d'un tokeniseur à l'autre : les mêmes 5 600 tokens de sortie donnent environ un tiers de mots en plus sur l'ancien tokeniseur (Opus 4.6, Sonnet 4.6, Haiku 4.5).
Deux mécanismes modifient l'addition. D'abord, la mise en cache du prompt (prompt caching). Les lectures en cache sont facturées à 10 % du tarif d'entrée de base sur la plupart des modèles, à 5 % sur Opus 5.5 ($0,20 par million de tokens) et à 2,5 % sur Fable 5.1 ($0,25 par million de tokens), Fable 5 restant à 10 % ($1 par million). Le travail itératif sur un long brouillon s'y prête parfaitement, à condition de ne jamais modifier le préfixe du prompt (prompt système, documentation chargée une fois et historique auquel on ne fait qu'ajouter des tours). Quant à la Batch API d'Anthropic, elle offre 50 % de remise dans les deux sens mais fonctionne de manière asynchrone, inadaptée à la rédaction interactive ; les tarifs de $1,50 et $7,50 parfois affichés à côté de Sonnet 4.6 correspondent à ce mode différé, et non au tarif standard de $3 et $15.
Ensuite, les tokens de réflexion (thinking tokens) sont facturés au tarif de sortie. Sur Fable 5.1 et Opus 5.5, la réflexion adaptative est activée en permanence : c'est donc le paramètre d'effort qui détermine combien vous dépensez en raisonnement préalable.
Le réglage d'effort : le levier que la plupart des auteurs négligent
Le guide d'Anthropic consacré à l'effort rappelle une règle essentielle : ajuster l'effort est souvent un meilleur levier que changer de modèle. L'effort est un paramètre de requête ; l'omettre revient à utiliser la valeur par défaut du modèle.
Cette valeur par défaut n'est plus uniforme. Opus 5.5 démarre sur medium. Tous les autres modèles actuels compatibles démarrent sur high. Haiku 4.5 ne prend pas en charge ce paramètre. Fable 5.1, Fable 5, Opus 5.5, Opus 5, Opus 4.8, Opus 4.7, Sonnet 5.5 et Sonnet 5 acceptent cinq paliers, de low à max. Opus 4.6 et Sonnet 4.6 acceptent max sans proposer xhigh.
Pour l'écriture, un effort plus élevé achète davantage de planification avant la première phrase : meilleures décisions de structure, respect plus Constant d'un cahier des charges long, attention accrue aux contraintes — au prix d'un temps de réponse et d'un coût supérieurs.
Sur Opus 5.5, le score d'écriture créative correspond à la ligne high, un cran au-dessus du réglage par défaut. Pour retrouver le comportement du classement, il faut donc monter le paramètre. Ne descendez en low que pour des réécritures rapides jetables, et montez en xhigh pour les chantiers structurels : réorganiser un chapitre, redresser une scène qui s'effondre ou respecter un brief très contraint.
Refus, ton et le reproche d'un « Sonnet devenu plus froid »
Lorsque les auteurs se plaignent d'un modèle, ils confondent souvent deux phénomènes : le refus pur et simple d'une requête, et l'exécution de la requête sur un ton sec et distancié.
Sur le ton, le reproche récurrent selon lequel Sonnet 5 serait plus sec que Sonnet 4.5 reste anecdotique, mais le tableau d'octobre pointe dans le même sens : Sonnet 5 en high se situe 19 points sous Sonnet 4.5 (1435 contre 1454), sans chevauchement d'intervalle. Sonnet 4.5 étant retiré le 30 novembre 2026, y revenir n'est pas une solution durable ; Sonnet 4.6, qui reste disponible, devance lui aussi Sonnet 5 d'une courte tête.
Sur les refus, Anthropic précise que Claude Fable 5.1, Claude Fable 5, Claude Opus 5.5, Claude Opus 5 et Claude Sonnet 5.5 embarquent des classificateurs de sécurité capables de décliner une requête, ceux d'Opus 5.5 couvrant un spectre plus large que ceux d'Opus 5. Aucun banc d'essai public ne mesure toutefois le taux de refus sur les tâches d'écriture créative.
Ce qui aide concrètement, c'est le cadrage : indiquez qu'il s'agit d'une fiction, précisez la forme, le genre et le lectorat visé, expliquez la fonction dramatique de la scène difficile dans l'intrigue et demandez uniquement le degré de détail requis par le récit.
Quel Claude pour quel profil d'auteur ?
Priorité au budget. Sonnet 4.6 à $3 et $15 par million de tokens. Sur le tableau d'écriture créative, il devance tout juste Sonnet 5 ($2 et $10). Si la facture prime sur ce mince écart, Sonnet 5 est l'option mesurée la plus économique. Sonnet 5.5 coûte le même prix que Sonnet 5, mais ses 658 votes ne permettent pas encore de juger s'il écrit mieux ou moins bien. Haiku 4.5 est encore moins cher mais recule au 133e rang.
Romanciers et récits longs. Opus 5.5 avec l'effort réglé sur high pour bénéficier de la configuration du classement. Il devance Opus 4.7 en high sans chevauchement d'intervalle et coûte $4 et $20 contre $5 et $25 pour Opus 4.7. Prenez en compte le nouveau tokeniseur lorsque vous dimensionnez la part du manuscrit gardée en contexte. Fable 5 constitue l'option supérieure si vous préférez un score assis sur 8 182 votes plutôt que 1 058, pour un tarif deux fois et demie plus élevé qu'Opus 5.5.
Contenu quotidien et rédaction à fort volume. Sonnet 4.6 par défaut, en réservant Opus 5.5 en high aux textes décisifs. À environ $0,13 la session, un texte par jour pendant un mois reste dérisoire face au temps gagné. Si vous cherchez simplement un premier jet sur lequel rebondir, décrivez votre sujet dans notre générateur de texte IA : il s'ouvre directement comme brouillon dans votre espace de travail, sans aucune configuration d'API.
Éditeurs et réviseurs. Fable 5, pour son avance en suivi d'instructions sur LiveBench : 75,8 en max contre 65,7 (max) et 67,0 (xhigh) pour Opus 5.5. Si votre budget reste calé sur les tarifs Opus, Opus 4.8 en max (72,0) conserve l'avantage sur Opus 5.5. Lorsqu'il s'agit d'appliquer une feuille de style, de maintenir une voix stable et d'opérer exactement les coupes demandées, testez-le sur un chapitre que vous connaissez déjà par cœur.
L'essentiel de la friction d'une journée d'écriture ne vient d'ailleurs pas du modèle : elle vient du brouillon ouvert dans un onglet, des recherches dans un deuxième, du plan dans un troisième, sans historique de versions. C'est précisément ce que nous avons voulu résoudre avec Muses : un espace d'écriture où le manuscrit, les notes, les sources et la révision assistée par IA cohabitent dans un même projet, avec l'historique nécessaire pour annuler une mauvaise passe de correction. La plateforme sélectionne et met à jour les modèles en coulisses, sans que vous ayez à gérer vous-même ces réglages par modèle. Essayez gratuitement.
Retrait des modèles : protégez votre flux d'écriture
Les recommandations de modèles ont une durée de vie limitée. Sonnet 4.5 a été déclaré obsolète le 30 septembre 2026 et sera retiré le 30 novembre 2026, avec claude-sonnet-5-5 comme remplaçant recommandé. C'est le seul modèle abordé ici qui possède une date de retrait ferme.
Haiku 4.5 reste listé comme actif, avec une date plancher fixée au 15 octobre 2026 mais sans annonce de retrait (la politique d'Anthropic prévoit un préavis d'au moins 60 jours). La date plancher suivante parmi les modèles cités est celle d'Opus 4.5, pas avant le 24 novembre 2026.
Les autres modèles disposent d'une marge confortable : Sonnet 4.6 au moins jusqu'au 17 février 2027, Opus 4.6 jusqu'au 5 février 2027, Opus 4.7 jusqu'au 16 avril 2027, Opus 4.8 jusqu'au 28 mai 2027, Sonnet 5 jusqu'au 30 juin 2027, Fable 5 jusqu'au 9 juin 2027, Opus 5 jusqu'au 24 juillet 2027, Fable 5.1 jusqu'au 1er septembre 2027, Opus 5.5 jusqu'au 22 septembre 2027 et Sonnet 5.5 jusqu'au 28 septembre 2027.
Si vous appelez directement l'API, épinglez l'identifiant exact du modèle (claude-opus-5-5, par exemple). Pour comparer les grandes familles d'outils d'écriture, consultez également notre documentation sur le choix de votre outil IA.
Comment nous tenons cette page à jour
Dernière vérification : 7 octobre 2026.
Nous révisons cette page chaque mois en vérifiant trois éléments : la gamme de modèles et leurs identifiants, les tarifs publiés et l'instantané des classements. Lorsqu'un score évolue suffisamment pour modifier une recommandation, le texte et la date de mise à jour évoluent avec lui.
Sources utilisées, toutes publiques :
- Jeu de données du classement LMArena — arène texte, sous-ensemble
style_control, catégoriecreative_writing, instantané du 2026-10-02. Scores Bradley-Terry issus de votes anonymes par paires. - LiveBench — jeu de questions 2026-06-25. Moyennes des catégories langue et suivi d'instructions relevées le 7 octobre 2026.
- Vue d'ensemble des modèles Anthropic — fenêtres de contexte, limites de sortie, tarifs, modes de réflexion, effort par défaut, coupures de connaissances et note sur le tokeniseur.
- Tarifs Anthropic — tarifs par MTok, multiplicateurs du cache de prompt et remise Batch API.
- Choisir le bon modèle et Effort — paliers d'effort et arbitrages entre réglage d'effort et changement de modèle.
- Refus et repli — modèles actuels dotés de classificateurs de sécurité.
- Obsolescence des modèles — cycle de vie, dates de retrait et politique de préavis.
Si vous souhaitez approfondir le métier d'écrire plutôt que le choix du modèle, notre guide pour améliorer son écriture détaille le cycle premier jet, prise de recul, retours et révision dans lequel s'intègre chacun de ces modèles.
Questions fréquentes
Quel est le meilleur modèle Claude pour écrire ?
Claude Opus 5.5 réglé sur l'effort high détient le score Claude le plus élevé au classement d'écriture créative avec contrôle du style (1516), mais son intervalle de confiance à 95 pour cent (1497 à 1536) chevauche Fable 5 en effort high (1503, intervalle 1495 à 1510) et Opus 4.6 en effort high (1501, intervalle 1494 à 1507). L'avance n'est donc pas définitivement acquise. De plus, high n'est pas le réglage par défaut d'Opus 5.5, qui démarre en medium. Fable 5.1, plus récent, plafonne à 1482 en effort max, en dessous de Fable 5. Sonnet 5.5 compte encore trop peu de votes pour être classé solidement.
Pour les textes longs, vaut-il mieux choisir Claude Opus 5.5 ou Claude Sonnet 5.5 ?
Opus 5.5, d'après les scores disponibles. En effort high, il atteint 1516 (intervalle 1497 à 1536). Sonnet 5.5 n'apparaît que sur une ligne xhigh à 1447 (intervalle 1424 à 1471 sur 658 votes) : les intervalles ne se croisent pas, mais l'échantillon de Sonnet 5.5 reste trop mince pour figer le classement. Opus 5.5 coûte 4 et 20 dollars par million de tokens, contre 2 et 10 dollars pour Sonnet 5.5. Notez que high n'est pas le réglage par défaut d'Opus 5.5 (medium) et que xhigh n'est pas celui de Sonnet 5.5 (high).
Quel modèle Claude privilégier pour la fiction et l'écriture créative ?
Claude Opus 5.5 en effort high affiche la meilleure estimation ponctuelle (1516). Si vous préférez un score voisin appuyé par un volume de votes beaucoup plus large, Fable 5 en effort high obtient 1503 sur 8 182 votes, contre 1 058 votes pour Opus 5.5, et leurs intervalles se chevauchent. Fable 5.1 en effort max ne reprend pas cette place : 1482, intervalle 1469 à 1494, nettement sous Fable 5. Évitez Haiku 4.5 pour la fiction, où il recule au 133e rang.
Claude Opus 5.5 et Fable 5 ont-ils été conçus pour l'écriture créative ?
Non. Anthropic présente Opus 5.5 comme le modèle destiné au codage agentique au long cours et au travail de connaissance, et conseille de commencer par lui pour la majorité des usages. Fable 5.1 vise le raisonnement complexe et les tâches agentiques à long horizon, tout comme Fable 5 avant lui. L'écriture créative ne figure pas parmi les cas d'usage officiels. Les scores de préférence sont bien réels : c'est un résultat observé, pas une intention de conception.
Quel modèle Claude utiliser par défaut pour écrire au quotidien ?
Sonnet 4.6, si vous cherchez un score de prose étayé par suffisamment de votes. Facturé 3 et 15 dollars par million de tokens, il obtient 1449 (intervalle 1443 à 1456), juste devant Sonnet 5 en effort high (1435, intervalle 1428 à 1442). Sonnet 5.5 est le Sonnet actuel et coûte moins cher (2 et 10 dollars), mais sa seule ligne en écriture créative est en xhigh avec 658 votes et un intervalle de 1424 à 1471 qui englobe les deux modèles précédents.
Claude peut-il écrire un livre entier ?
Il peut en contenir un dans sa mémoire de travail. Une fenêtre de contexte d'un million de tokens représente environ 555 000 mots anglais avec le tokeniseur actuel, de sorte qu'un roman entier tient dans une seule session. Produire un bon livre en une seule génération est un tout autre problème, qu'aucun modèle ne résout. La méthode efficace consiste à avancer chapitre par chapitre, en gardant le plan et la feuille de style dans le contexte et en révisant chaque chapitre avant de passer au suivant.
Comment conserver ma propre voix lorsque j'écris avec Claude ?
Donnez au modèle votre propre texte comme matière première au lieu de lui demander d'inventer de la prose « dans votre style ». Collez deux ou trois passages que vous avez écrits, énoncez vos règles d'écriture et demandez des pistes de coupe ou des notes de structure plutôt que des paragraphes finis. Réécrivez ensuite ses propositions avec vos propres mots. Une voix d'auteur résiste bien mieux à la révision qu'à la génération pure.
Pourquoi Claude refuse-t-il certaines demandes d'écriture créative, et quel modèle refuse le moins ?
Anthropic documente la présence de classificateurs de sécurité susceptibles de décliner une requête sur Claude Fable 5.1, Claude Fable 5, Claude Opus 5.5, Claude Opus 5 et Claude Sonnet 5.5. La sensibilité varie d'un modèle à l'autre, mais aucun banc d'essai public ne mesure le taux de refus en écriture créative. En pratique, la solution repose sur le cadrage : précisez qu'il s'agit d'une œuvre de fiction, indiquez le genre et le lectorat visé, expliquez le rôle dramatique de la scène difficile dans le récit et demandez uniquement le degré de détail nécessaire.