執筆に最適なClaudeモデルは?(2026年版)Opus 5.5が首位に立つも、差はまだ僅差
創作ライティングのリーダーボードではOpus 5.5がClaude勢で最高スコアを記録していますが、Fable 5やOpus 4.6との差はまだ確定していません。初稿執筆・推敲・日常の執筆それぞれの最適解と料金を解説します。
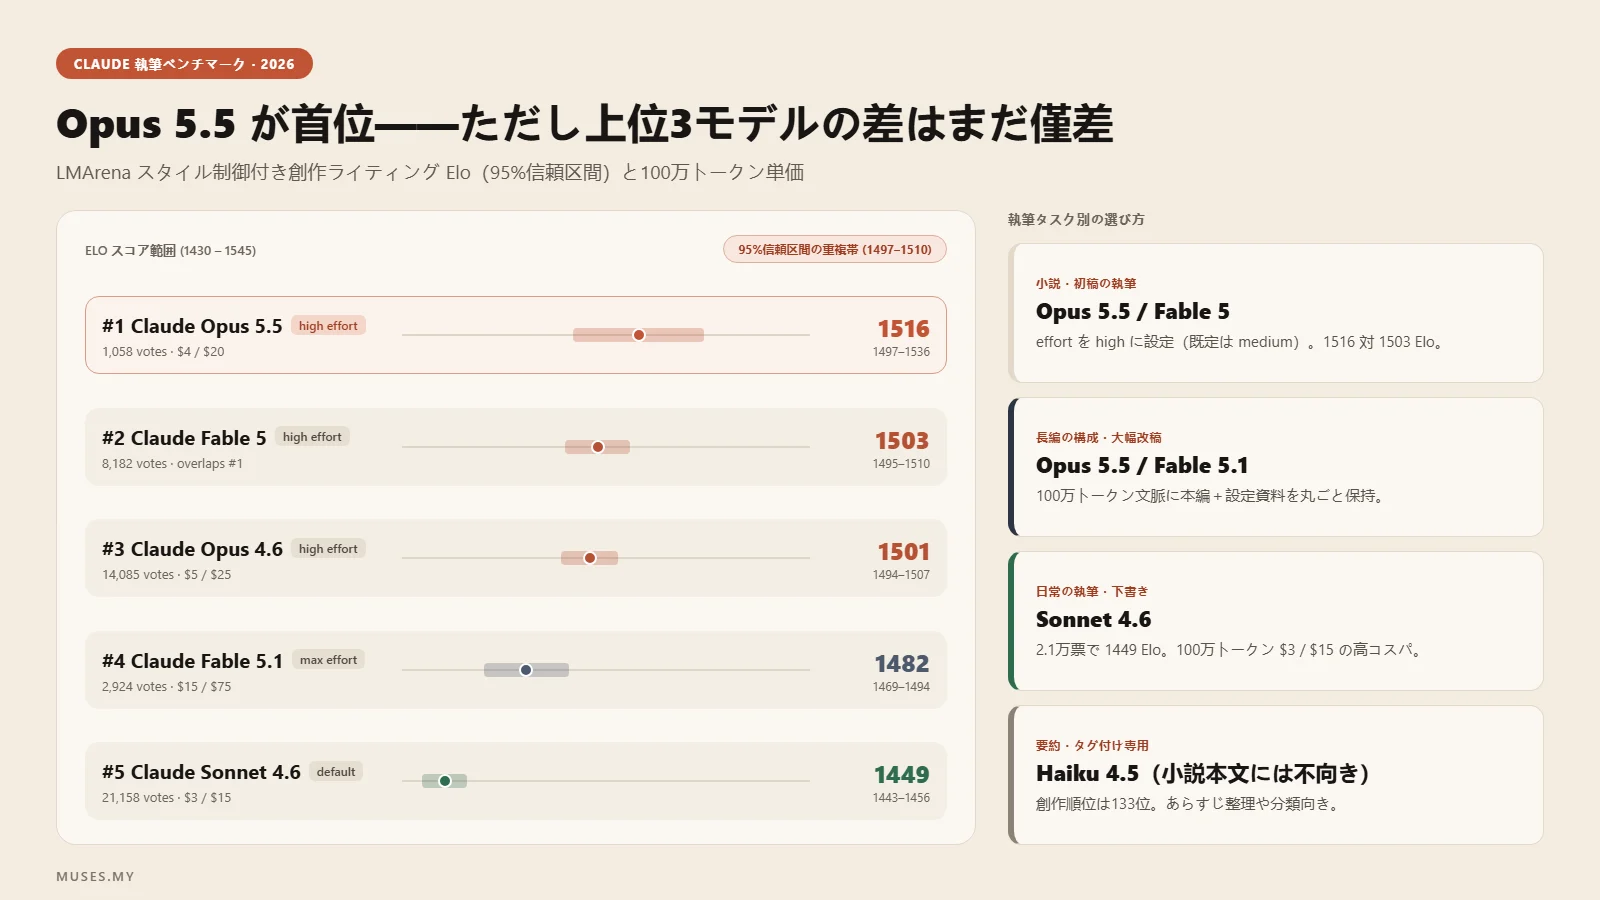
表に入る前に結論からお伝えします。最新のOpusは創作ライティングでClaude勢の最高スコアを記録していますが、単独首位が固まったわけではありません。LMArenaの文体補正済み(style-controlled)創作ライティング・リーダーボード(2026年10月2日時点のスナップショット)では、effortをhighに設定したClaude Opus 5.5が1516を獲得しました。ただし、その95%信頼区間はeffort highのClaude Fable 5およびClaude Opus 4.6と重なっており、投票数も後者2モデルの8,182票・14,085票に対してOpus 5.5は1,058票にとどまります。新しいFable 5.1はFable 5を下回り、新しいSonnet 5.5はまだ判定に足る票数が集まっていません。
モデル名から受ける印象とはずいぶん異なる結果です。Anthropicの現在の公式案内は「大半のワークロードはまずOpus 5.5から始め、より高度な推論が必要でOpus 5.5のeffortを上げても足りない場合にFable 5.1へ進む」というものです。公式が掲げる主な用途はエージェント型コーディング、ナレッジワーク、長期タスクであり、創作ライティングは含まれていません。それでも人間の好みによる投票結果は、このモデルを上位に押し上げました。
私たちはAI統合型の執筆ワークスペース「Muses」を開発しており、カーソルの背後で動くモデルが原稿の質を左右するからこそ、最先端モデルの検証と統合を続けています。本記事のデータはすべて公開情報(LMArenaリーダーボードのデータセット、LiveBench、Anthropic公式ドキュメント)に基づいています。長編原稿における一貫性や、どのモデルが最もリクエストを拒否しにくいかといった公開データが存在しない領域については、推測で穴埋めせず「データがない」と明記します。
結論:執筆にはどのClaudeモデルを選ぶべきか?
| 用途・作業内容 | 最初に選ぶモデル | 100万トークン料金(入力 / 出力) | 理由 |
|---|---|---|---|
| 小説の初稿・創作散文 | Claude Opus 5.5(effort high) | $4 / $20 | 文体補正済み創作ライティングボードでClaude勢の最高点。信頼区間はhighのFable 5およびOpus 4.6と重なる。highはOpus 5.5のデフォルトより1段階上の設定 |
| 同じ用途で、より多くの票数に裏づけられたスコアを重視する場合 | Claude Fable 5(effort high) | $10 / $50 | 8,182票に基づく1503で、Opus 5.5と同じ信頼区間帯に入る。Fable 5.1はこの位置に届かない |
| 長編原稿の執筆 | Claude Opus 5.5(effort high) | $4 / $20 | highのOpus 4.7を信頼区間の重なりなしで上回り、旧Opus価格($5 / $25)より安い。新トークナイザー採用のため、同じ1MでもOpus 4.6より入る文字量は減る |
| 文体ルール(スタイルシート)に沿った推敲・改稿 | Claude Fable 5、またはOpus価格帯ならOpus 4.8 | $10 / $50、または $5 / $25 | LiveBenchの指示追従(effort max):Fable 5が75.8、Fable 5.1が73.0、Opus 4.8が72.0。Opus 5.5のmaxは65.7 |
| コストを抑えた日常の執筆 | Claude Sonnet 4.6 | $3 / $15 | 十分な票数があり信頼できる。Sonnet 5をわずかに上回る。現行のSonnet 5.5は658票のみでまだ順位を確定できない |
| 大量生成・低リスクのコピー作成 | Claude Haiku 4.5 | $1 / $5 | 1セッションあたり約4セント。創作ボードでは133位で、退役下限日が最も近い点に注意 |
1文でまとめるなら、2026年10月現在、初稿執筆の第一候補はeffortをhighにしたOpus 5.5、数千票多い実績を優先するならFable 5、Opus価格帯で厳密な推敲・改稿を行うならOpus 4.8、毎日の執筆にはSonnet 4.6です。まずはこの候補をご自身の原稿で試してみてください。リリース順でもなければ、「常に最新モデルを買えばよい」という話でもありません。
書き手のための2026年Claudeラインナップ
Anthropicのモデル概要に基づく現行ラインナップは以下のとおりです。迷った場合はOpus 5.5から始め、effortを上げてテストしてもまだ足りない場合にFable 5.1を使うのがAnthropicの公式推奨です。
| モデル | コンテキスト | 最大出力 | 100万トークン料金(入力 / 出力) | 思考(Thinking) | デフォルトeffort | 信頼できる知識カットオフ |
|---|---|---|---|---|---|---|
| Claude Fable 5.1 | 1M | 128K | $10 / $50 | アダプティブ(常時オン) | high | 2026年6月 |
| Claude Opus 5.5 | 1M | 128K | $4 / $20 | アダプティブ(常時オン) | medium | 2026年6月 |
| Claude Sonnet 5.5 | 1M | 128K | $2 / $10 | アダプティブ | high | 2026年6月 |
| Claude Haiku 4.5 | 200K | 64K | $1 / $5 | Extended | 非対応 | 2025年2月 |
現在もAPI経由で利用可能ですが、Anthropicが現行ではなくレガシー(旧世代)に分類しているモデルとして、Fable 5、Opus 5、Opus 4.8 / 4.7 / 4.6 / 4.5、Sonnet 5、Sonnet 4.6があります。Opus 5およびOpus 4.8〜4.5は$5 / $25で、Opus 5.5より高価です。Fable 5はFable 5.1と同額の$10 / $50、Sonnet 5はSonnet 5.5と同額の$2 / $10です。Sonnet 4.6は$3 / $15のままで、新しいSonnetより安くはありません。Sonnet 4.5は2026年9月30日に非推奨(deprecated)となり、2026年11月30日に退役します。
原稿の分量をコンテキストウィンドウと照らし合わせる前に、押さえておくべき変更点が1つあります。AnthropicはOpus 4.7以降でトークナイザーを変更しました。現行トークナイザーでは100万トークンが英語で約55万5,000語に相当しますが、旧トークナイザーでは同じ100万トークンに約75万語が収まりました。Anthropicの料金ドキュメントによると、同じテキストでもトークン数が約30%増加します。Fable 5.1、Opus 5.5、Sonnet 5.5、Fable 5、Opus 5、Sonnet 5、Opus 4.8、Opus 4.7はすべて新トークナイザーを使用しており、Sonnet 4.6、Opus 4.6、Sonnet 4.5、Haiku 4.5は旧トークナイザーを使用しています。カタログ上の数字は同じ「1M」でも、Opus 5.5のウィンドウに収まる小説の分量はOpus 4.6より実質的に少なくなります。
文体補正済みリーダーボードが実際に示していること
LMArenaは匿名ユーザーによる1対1の比較投票を集め、Bradley-Terryモデルでレーティングを算出しています。文体補正(style_control)は、文章そのものの質とは別に票を集めやすいフォーマット上の癖(回答の長さや、見出し・箇条書きの多用など)を補正する仕組みです。以下の数値は、LMArenaリーダーボード・データセット(2026年10月2日時点のスナップショット)のテキストアリーナ、style_controlサブセット、creative_writingカテゴリから取得し、整数に四捨五入したものです。
| モデル | アリーナでのバリアント名 | レーティング | 全体順位 | 95%信頼区間 | 投票数 |
|---|---|---|---|---|---|
| Claude Opus 5.5 | claude-opus-5.5-high | 1516 | 2 | 1497–1536 | 1,058 |
| Claude Fable 5 | claude-fable-5-high | 1503 | 3 | 1495–1510 | 8,182 |
| Claude Opus 4.6 | claude-opus-4-6-high | 1501 | 4 | 1494–1507 | 14,085 |
| Claude Opus 4.7 | claude-opus-4-7-high | 1489 | 6 | 1482–1496 | 11,812 |
| Claude Fable 5.1 | claude-fable-5.1-max | 1482 | 10 | 1469–1494 | 2,645 |
| Claude Opus 5 | claude-opus-5-high | 1471 | 13 | 1465–1478 | 13,263 |
| Claude Opus 4.8 | claude-opus-4-8-high | 1470 | 17 | 1463–1476 | 12,798 |
| Claude Sonnet 4.5 | claude-sonnet-4-5-20250929 | 1454 | 33 | 1448–1460 | 12,367 |
| Claude Sonnet 4.6 | claude-sonnet-4-6 | 1449 | 38 | 1443–1456 | 12,339 |
| Claude Sonnet 5.5 | claude-sonnet-5.5-xhigh | 1447 | 42 | 1424–1471 | 658 |
| Claude Sonnet 5 | claude-sonnet-5-high | 1435 | 65 | 1428–1442 | 9,413 |
| Claude Haiku 4.5 | claude-haiku-4-5-20251001 | 1388 | 133 | 1383–1393 | 24,158 |
ここで見落としてならないのが、バリアント名末尾のeffortラベルです。
Opus 5.5の行はhighですが、APIのデフォルト設定はmediumです。パラメータを省略して呼び出すと、このスコアの設定にはなりません。Fable 5、Opus 4.6、Opus 4.7、Opus 4.8、Sonnet 5はすべてhighで記録されており、これは各モデルのデフォルト設定と一致します。Fable 5.1はデフォルトのhighより1段階上のmaxしか掲載されていません。Sonnet 5.5もデフォルトのhighより上のxhigh(658票)のみの掲載です。Sonnet 4.6、Sonnet 4.5、Haiku 4.5にはeffortの接尾辞がなく、Haiku 4.5はそもそもeffortパラメータに非対応です。
Claude勢におけるOpus 5.5の1位は「点推定値」であり、独走ではありません。 1497–1536という信頼区間は、Fable 5(1495–1510)およびhighのOpus 4.6(1494–1507)と重なっています。一方で、highのOpus 4.7(1482–1496)に対しては区間の重なりなしで上回っており、8月時点で長文向きとして推奨していたモデルから確かな前進を見せています。なお、他社モデルに目を向けるとeffort highのGemini 4 Argonが1519(全体1位、区間1499–1538)を記録しており、この区間もOpus 5.5と重なっています。
Fable 5.1はFable 5の座を引き継いでいません。 公表されている唯一の行であるeffort maxの区間が1469–1494であるのに対し、highのFable 5は1495–1510で、両者の区間は重なりません。「新しいモデルを最大effortで動かしたほうがよく書けるはずだ」という直感とは逆の結果が出ています。
Sonnet勢の並びでは、Sonnet 4.5(1454、区間1448–1460)が依然としてhighのSonnet 5(1435、区間1428–1442)を上回っていますが、2026年11月30日に退役するため今から採用すべきではありません。Sonnet 4.6(1449、区間1443–1456)もSonnet 5をわずかに上回っています(境界値は1443対1442で1ポイント差)。Sonnet 5.5の区間(1424–1471)は658票と少ないため幅が広く、Sonnet 4.6・Sonnet 5・Sonnet 4.5のすべてを覆っています。
また、旧Opus価格($5 / $25)のモデル間では、highのOpus 4.7(1482–1496)がhighのOpus 4.8(1463–1476)を引き続き上回っています。highのOpus 5.5はそのOpus 4.7をさらに上回り、しかも低価格です。
人間の好みによる投票は1つの軸にすぎません。LiveBench(問題セット2026-06-25、2026年10月7日取得)では言語能力(language)と指示追従(instruction following)を別々に採点しており、順位は大きく入れ替わります。
言語カテゴリでは、effort maxのFable 5が90.7でClaude勢のトップに立ち、Fable 5.1(max)が89.5、Opus 5(max)が88.7、Opus 5.5(max)が86.3と続きます。最新のOpusは言語カテゴリの首位ではなく、前世代のOpus 5の後塵を拝しています。
指示追従カテゴリではさらに順位が変動します。全体首位はeffort highのGemini 3.8 Flash(81.4)で、Claude勢の最高はFable 5(max)の75.8、次いでFable 5.1(max)の73.0、Opus 4.8(max)の72.0です。Opus 5.5はxhighで67.0、maxで65.7にとどまります。Sonnet 5.5はxhighで70.5、maxで56.8と大きく振れています。「文章が上手い」ことを一括りにできる単一のスコアは存在しません。
いいえ、ライティング首位は「創作特化モデル」ではありません
かつてFable 5という名前から「創作向けのモデルだ」と誤解されることがありました。今またOpus 5.5がライティングボードの首位に立ったことで、「Anthropicが推奨する基本モデルは散文向けに調整されているのだ」と思われがちですが、公式ドキュメントの説明は異なります。
モデル概要ページでは、大半のワークロードをClaude Opus 5.5から始め、高度な推論や長期のエージェント作業にはClaude Fable 5.1を使うよう案内しています。Opus 5.5のモデルページは長時間のエージェント型コーディングと知識作業向け、Fable 5.1のモデルページはより強力なエージェント型コーディング、複数ステップの調査、ドキュメント処理向けと記しています。いずれの公式ユースケースにも創作ライティングは挙がっていません。
8月時点では高価な汎用モデルであるFable 5(2026年6月9日公開)がライティングボードの頂点にありましたが、10月時点ではAnthropicが大多数のユーザーに最初の選択肢として勧めるOpus 5.5(2026年9月22日公開)が、FableやOpus 5より低い価格で最高点を記録しています。書き手にとってはありがたい一致ですが、あくまで結果としての一致です。
初稿執筆、推敲・編集、長編管理はまったく別の仕事
「執筆」を1つの能力として捉えると、モデル選びを誤ります。少なくとも以下の3つに分けて考える必要があります。
**初稿執筆(ドラフティング)**では、読者が読んで心地よいと感じる文章が評価されます。プロンプトやアウトラインから新しい散文を書き起こすなら、リーダーボードが示すとおりeffort highのOpus 5.5が有力候補となり、highのFable 5とOpus 4.6が同じ信頼区間に入ります。Opus 5.5をhighに設定しなければ、1516を獲得した構成にはなりません。
**推敲・編集(エディティング)**は別のスキルです。文体を維持したまま15%削る、会話文には手をつけない、指定の表記ルールを適用するといった作業は「指示追従」そのものであり、LiveBenchでは順位が入れ替わります。effort maxのFable 5が75.8でClaude勢を牽引し、Fable 5.1(max、73.0)、Opus 4.8(max、72.0)が続き、Opus 5.5はxhighで67.0、maxで65.7とOpus 4.8の後方に回ります。
長編原稿の管理は、コンテキスト容量とセッションをまたいだ一貫性に左右されます。容量自体は100万トークン(新トークナイザーで英語約55万5,000語)と明記されていますが、一貫性を測る公開ベンチマークは存在しません。6万語のプロジェクトの途中で文体がぶれないか、第20章で登場人物の口調を忘れないか、40回目の改稿で文のリズムが平坦にならないかといった点は、現在私たちが独自の構造化テストを構築して検証を進めています。
4ターンの執筆セッションに実際いくらかかるのか
以下は実測値ではなく、Anthropicの公表料金を現実的なセッション構成に当てはめた試算モデルです。モデル間の相対的なコスト感を把握するための目安としてご覧ください。
| 前提条件 | 設定値 |
|---|---|
| 1セッションあたりの生成回数 | 4回(初稿1回+改稿3パス) |
| 1回あたりの入力トークン数 | 約4,000トークン(指示、現在の原稿、メモ) |
| 1回あたりの出力トークン数 | 約1,400トークン |
| セッション合計 | 入力 16,000トークン、出力 5,600トークン |
旧トークナイザーでは出力1,400トークンが英語約1,050語、現行トークナイザーでは約780語に相当します。公表されている100万トークン単価を適用すると以下のようになります。
| モデル | 生成語数(英語換算) | 入力コスト | 出力コスト | 1セッションあたり合計 |
|---|---|---|---|---|
| Claude Fable 5 / Fable 5.1 | ≈780語 | $0.160 | $0.280 | $0.44 |
| Claude Opus 5 / 4.8 / 4.7 | ≈780語 | $0.080 | $0.140 | $0.22 |
| Claude Opus 5.5 | ≈780語 | $0.064 | $0.112 | $0.18 |
| Claude Sonnet 4.6 | ≈1,050語 | $0.048 | $0.084 | $0.13 |
| Claude Sonnet 5 / Sonnet 5.5 | ≈780語 | $0.032 | $0.056 | $0.09 |
| Claude Haiku 4.5 | ≈1,050語 | $0.016 | $0.028 | $0.04 |
「生成語数」の列はトークナイザーの世代をまたいで直接比較できません。旧トークナイザーを使うOpus 4.6やSonnet 4.6では、同じ5,600出力トークンで約3割多くの単語が得られます。
ここから2つの要素が実際の請求額を動かします。1つ目はプロンプトキャッシュです。キャッシュ読み取りは多くのモデルで基本入力料金の10%、Opus 5.5では5%(100万トークンあたり$0.20)、Fable 5.1では2.5%(同$0.25)で課金されます(Fable 5は10%の$1)。長編原稿の反復改稿とは相性が良いものの、割引が効くのはシステムプロンプトや最初に読み込んだ設定資料など「先頭から変化しないプレフィックス部分」だけです。またAnthropicのBatch APIは入出力とも50%割引になりますが、非同期処理のため対話的な執筆には向きません。
2つ目は逆方向の要素で、思考トークン(Thinking tokens)が出力として課金される点です。Fable 5.1とOpus 5.5ではアダプティブ思考が常時オンになっておりオフにできないため、どれだけ思考トークンを使うかはeffortパラメータで制御します。
見落とされがちな最重要レバー:effort(思考強度)設定
Anthropicのeffortガイドには「モデルを切り替えるより、effortを調整するほうが効果的な場合が多い」と記されています。effortはリクエストパラメータであり、省略すると各モデルのデフォルト値が使われます。
現在、そのデフォルト値はモデルによって異なります。Opus 5.5のデフォルトはmediumですが、effortに対応する他の現行モデルはすべてhighがデフォルトです(Haiku 4.5は非対応)。Fable 5.1、Fable 5、Opus 5.5、Opus 5、Opus 4.8、Opus 4.7、Sonnet 5.5、Sonnet 5はlowからmaxまでの5段階に対応し、Opus 4.6とSonnet 4.6はxhighを除くmaxまでに対応しています。
執筆において高いeffortは「最初の1文を書き出す前の設計時間」を買うことに相当します。構成の判断が緻密になり、長い指示書の細部まで目が行き届く一方、時間と出力トークンを多く消費します。
Opus 5.5でリーダーボードの1516点を再現するには、デフォルトのmediumから1段階上げてhighを指定する必要があります。逆に捨て案の素早い書き直しならlowに下げ、章全体の再構成や複雑な制約条件のクリアにはxhighへ引き上げます。Fable 5、Opus 4.7、Opus 4.8、Sonnet 5はデフォルトがhighなので、そのまま表の構成と一致します。
リクエスト拒否、文体の温度感、そして「Sonnetが冷たくなった」という声
書き手がモデルへの不満を口にするとき、「リクエスト自体が拒否されること」と「リクエストには応じるが文体が素っ気ないこと」が混同されがちです。
文体のトーンに関して、「Sonnet 5はSonnet 4.5より乾いた文章になった」というコミュニティの感想は、10月のリーダーボードの数字とも符合しています。highのSonnet 5(1435)はSonnet 4.5(1454)を19ポイント下回り、信頼区間も重なりません。ただしSonnet 4.5は2026年11月30日に退役するため、今後の移行先としてはSonnet 5を上回るSonnet 4.6が現実的です。
安全上の拒否(Refusals)については、Claude Fable 5.1、Fable 5、Opus 5.5、Opus 5、Sonnet 5.5に安全分類器が搭載されていることが公式に文書化されています。Opus 5.5の分類器はOpus 5より広いカテゴリをカバーしています。
実務上で効果的なのは、人間の編集者に原稿を渡すときと同じように文脈を伝えることです。フィクション作品であること、ジャンルと対象読者、その場面が物語の中で果たす役割(登場人物が何を失い、後の展開にどうつながるか)を明記し、場面に必要な描写の粒度だけを指定してください。
書き手のタイプ別・おすすめのClaudeモデル
コスト最優先なら。 100万トークンあたり$3 / $15のSonnet 4.6です。創作ボードでSonnet 5($2 / $10)をわずかに上回ります。その僅差よりも請求額を抑えたい場合は、票数が十分に集まっているSonnet 5が最も安価な選択肢になります。
小説家・長編ノンフィクション作家なら。 effortをhighに設定したOpus 5.5です。highのOpus 4.7($5 / $25)を信頼区間の重なりなしで上回り、料金も$4 / $20に下がります。新トークナイザーによる文字量の減少だけ計算に入れておきましょう。1,058票より8,182票の実績を重視するなら、トークン単価は2.5倍になりますがFable 5がアップグレード先になります。
毎日のコンテンツ制作・多作なライターなら。 デフォルトにSonnet 4.6を据え、ここぞという原稿にだけeffort highのOpus 5.5を投入する組み合わせです。1セッション約$0.13なので、毎日1本書いても月あたりのコストはごくわずかです。まずはたたき台となる初稿を素早く作って手直ししたいだけなら、当社のAIテキストジェネレーターに内容を入力すれば、API設定なしでワークスペース上に直接ドラフトを開けます。
編集者・リライターなら。 LiveBenchの指示追従スコアで75.8(max)を記録しているFable 5、あるいはOpus価格帯に収めるなら72.0(max)のOpus 4.8です。スタイルシートの適用、文体の維持、指定文字数の圧縮といった用途では、よく知っている章を使ってまずこの2モデルを試してみてください。
日々の執筆で最大のストレスになるのは、実はモデルそのものではありません。原稿は最初のタブ、資料は2つ目のタブ、アウトラインは3つ目のタブに散らばり、どこにもバージョン履歴がない状態です。私たちが開発したMusesは、原稿・キャラクター設定・資料・AIによる推敲を1つのプロジェクトにまとめ、いつでも前の版に戻せる履歴機能を備えた執筆ワークスペースです。背後で動くモデルはプラットフォーム側で選定・更新されるため、モデルごとの細かいパラメータ調整に悩む必要もありません。無料で試してみる
モデルの退役スケジュール:執筆ワークフローを守るために
モデルの推奨には賞味期限があります。Sonnet 4.5は2026年9月30日に非推奨となり、2026年11月30日に退役します(推奨移行先はclaude-sonnet-5-5)。本記事で扱ったモデルのなかで、確定した退役日が出ているのはこのモデルだけです。
Haiku 4.5は引き続きアクティブですが、退役下限日は2026年10月15日以降とされています(ただしAnthropicは退役の最低60日前に告知する規定のため、まだ退役日は確定していません)。次に下限日が近いのはOpus 4.5(2026年11月24日以降)です。
その他のモデルには十分な猶予があります。Sonnet 4.6は2027年2月17日、Opus 4.6は2027年2月5日、Opus 4.7は2027年4月16日、Opus 4.8は2027年5月28日、Sonnet 5は2027年6月30日、Fable 5は2027年6月9日、Opus 5は2027年7月24日、Fable 5.1は2027年9月1日、Opus 5.5は2027年9月22日、Sonnet 5.5は2027年9月28日がそれぞれの退役下限日(「この日より前には退役しない」日付)です。
APIを直接呼び出す場合は、claude-opus-5-5のように正確なモデルIDを固定して指定しましょう。執筆ツールの種類ごとの違いや選び方については、公式ドキュメントのAIツールの選び方もあわせてご参照ください。
本記事の更新方針と出典
最終検証日:2026年10月7日
私たちは毎月この記事を見直し、モデルラインナップとID、公表料金、リーダーボードのスナップショットの3点を検証しています。推奨が変わるほどのスコア変動があれば、記事本文と更新日を改訂します。
参照した公開ソース:
- LMArena リーダーボード・データセット — テキストアリーナ、
style_controlサブセット、creative_writingカテゴリ(2026-10-02スナップショット)。匿名ペアワイズ投票によるBradley-Terryレーティング。 - LiveBench — 問題セット2026-06-25。2026年10月7日時点の
languageおよびinstruction followingカテゴリ平均値。 - Anthropic モデル概要 — コンテキストウィンドウ、最大出力、料金、思考モード、デフォルトeffort、知識カットオフ、トークナイザーに関する注記。
- Anthropic 料金ページ — 100万トークン単価、プロンプトキャッシュ倍率、Batch API割引。
- モデルの選び方およびEffort設定 — effortレベルとモデル切り替えに関する公式ガイド。
- 拒否とフォールバック — 安全分類器を搭載している現行モデルの仕様。
- モデルの非推奨・退役スケジュール — ライフサイクル、退役日、事前告知ポリシー。
モデル選びではなく文章技術そのものを磨きたい方は、初稿・距離置き・フィードバック・推敲のサイクルを解説した文章力を高める実践ガイドもぜひお読みください。
よくある質問
文章執筆にはどのClaudeモデルが一番おすすめですか?
文体補正済みの創作ライティング・リーダーボードでは、effortをhighに設定したClaude Opus 5.5が1516でClaude勢の最高点を記録しています。ただし95%信頼区間(1497〜1536)は、effort highのFable 5(1503、区間1495〜1510)およびOpus 4.6(1501、区間1494〜1507)と重なっており、単独首位が確定したわけではありません。またOpus 5.5の初期設定はmediumであり、そのままではhighになりません。新しいFable 5.1はeffort maxで1482にとどまり、Fable 5を下回っています。Sonnet 5.5はまだ票数が少なく順位を確定できません。
長文を書く場合、Claude Opus 5.5とSonnet 5.5のどちらが向いていますか?
現在公表されているスコアで見ればOpus 5.5です。effort highで1516(区間1497〜1536)を記録しています。一方、Sonnet 5.5はxhighの1447(658票、区間1424〜1471)しかデータがなく、信頼区間こそ重ならないものの、確定順位として扱うには票数が少なすぎます。100万トークンあたりの料金はOpus 5.5が入力4ドル・出力20ドル、Sonnet 5.5が入力2ドル・出力10ドルです。なお、Opus 5.5のデフォルトはmedium、Sonnet 5.5のデフォルトはhighです。
小説や創作ライティングに最も強いClaudeモデルはどれですか?
点推定値が最も高いのはeffort highのClaude Opus 5.5(1516)です。より多くの票数に裏づけられたスコアを重視するなら、effort highのFable 5が8,182票を集めて1503を記録しており(Opus 5.5は1,058票)、両者の信頼区間は重なっています。effort maxのFable 5.1は1482(区間1469〜1494)でFable 5には届きません。小説執筆でHaiku 4.5は避けましょう(同ボードで133位)。
Claude Opus 5.5やFable 5は創作ライティング向けに作られたモデルなのですか?
いいえ。AnthropicはOpus 5.5を長時間のエージェント型コーディングや知的作業向けのモデルと位置づけており、大半の業務でまずこのモデルから始めるよう案内しています。Fable 5.1もFable 5と同様、高度な推論や長期的なエージェント作業向けです。公式のユースケースに創作ライティングは含まれていません。リーダーボードの高評価は実際の投票結果として生まれたものであり、設計上の意図ではありません。
日常的な文章作成でデフォルトにすべきClaudeモデルはどれですか?
十分な票数に裏づけられた文章力を求めるならSonnet 4.6です。100万トークンあたり入力3ドル・出力15ドルで、スコアは1449(区間1443〜1456)と、effort highのSonnet 5(1435、区間1428〜1442)をわずかに上回ります。現行のSonnet 5.5は2ドル・10ドルと安価ですが、創作ライティングの記録はxhighの658票(区間1424〜1471)のみで、上記2モデルの両方を区間に含んでしまうためまだ優劣を判定できません。
Claudeで本を丸ごと1冊書くことはできますか?
1冊分のテキストを保持すること自体は可能です。100万トークンのコンテキストウィンドウは現行トークナイザーで英語約55万5,000語に相当するため、長編小説1冊が1つの会話に収まります。ただし、1回の生成で良質な本を書き上げることはどのモデルにもできません。実用的なワークフローは、アウトラインと文体ルールをコンテキストに置いたまま1章ずつ執筆し、各章を推敲してから次へ進む進め方です。
Claudeを使いつつ自分の文体を保つにはどうすればよいですか?
自分の作風でゼロから文章を書かせるのではなく、自分が書いたテキストを素材として渡すのが効果的です。自作の段落を2〜3個貼り付け、守っている文体ルールを明示したうえで、完成稿ではなく修正案や構成メモを求めます。そしてモデルの出力を自分の言葉で書き直してください。作家固有の声は、ゼロからの生成より推敲のほうがはるかに残りやすいため、最終稿の手入れは必ず自分で行いましょう。
創作ライティングのリクエストがClaudeに拒否されることがあるのはなぜですか?最も拒否が少ないモデルはどれですか?
Anthropicの公式ドキュメントによれば、Claude Fable 5.1、Fable 5、Opus 5.5、Opus 5、Sonnet 5.5にはリクエストを拒否する場合がある安全分類器が搭載されています。拒否の挙動はモデルごとに異なりますが、創作分野での拒否率を測定した公開ベンチマークは存在しないため、順位づけはできません。実務で有効なのは回避策ではなく文脈の提示です。フィクションであること、ジャンルと想定読者、重い場面が物語上で果たす役割を説明し、必要な描写レベルだけを求めるようにしてください。