Melhor modelo Claude para escrever (2026): o Opus 5.5 lidera, mas a vantagem ainda está aberta
O Opus 5.5 tem a maior pontuação entre os modelos Claude em escrita criativa, mas a vantagem sobre o Fable 5 e o Opus 4.6 não está fechada. Veja qual escolher para rascunho, revisão e textos do dia a dia, com preços.
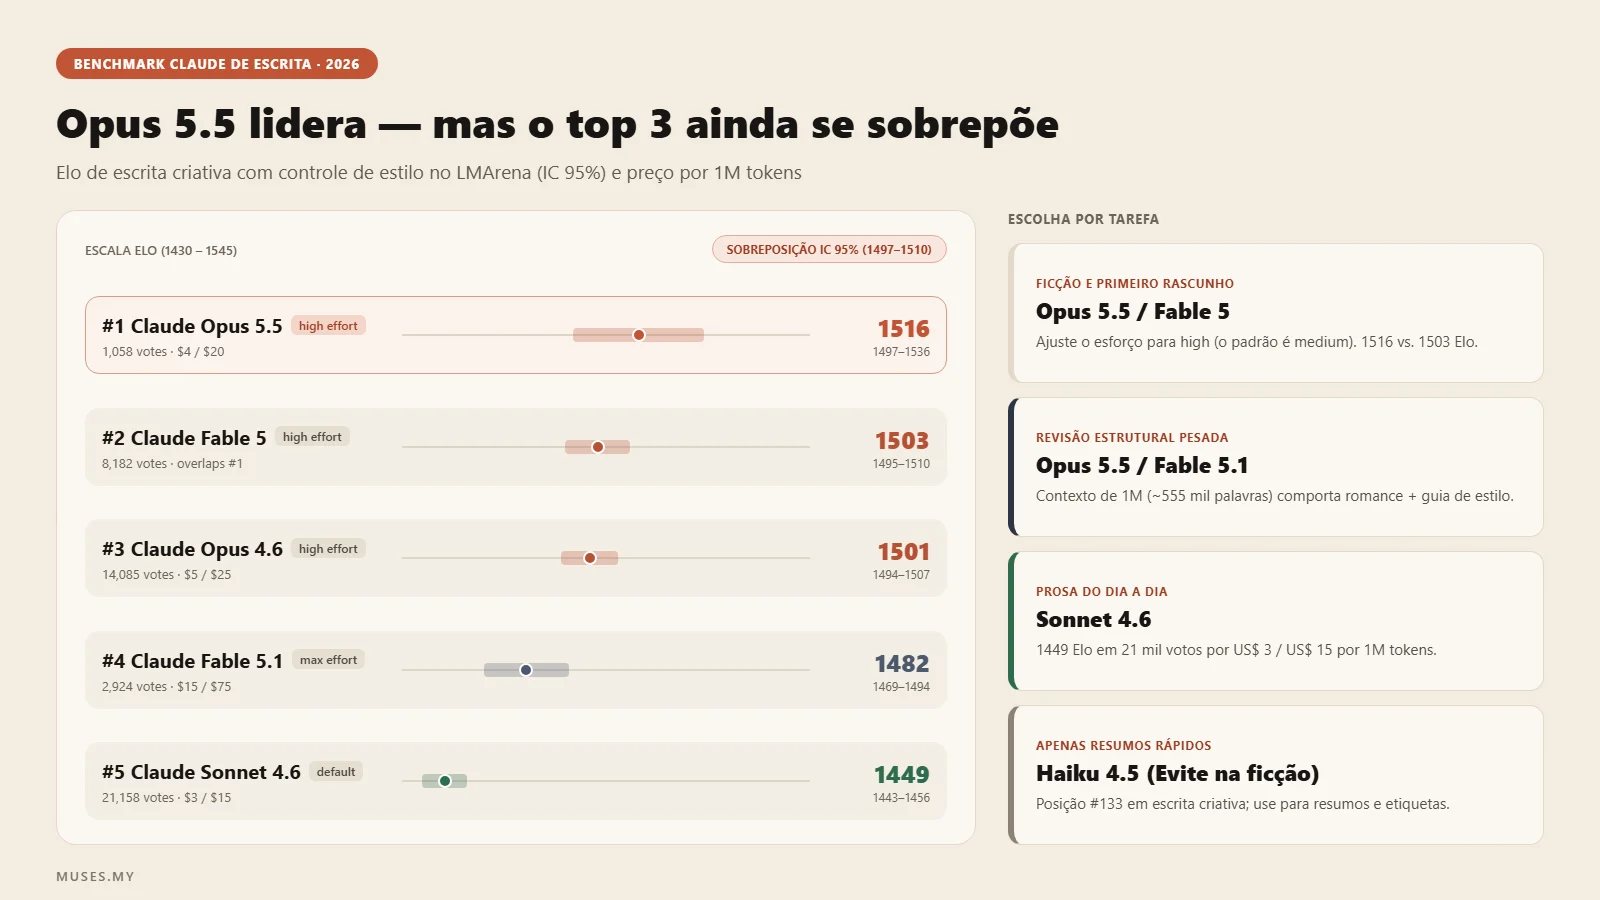
Versão curta, antes das tabelas: o Opus mais recente tem a maior nota entre os modelos Claude para escrita criativa, mas a liderança ainda não está decidida. No ranking de escrita criativa com controle de estilo da LMArena, no retrato de 2 de outubro de 2026, o Claude Opus 5.5 com esforço high marca 1516. Seu intervalo de confiança se sobrepõe ao Claude Fable 5 em high e ao Claude Opus 4.6 em high, sendo que a linha do Opus 5.5 se apoia em 1.058 votos, contra 8.182 e 14.085 daqueles dois. O Fable mais novo, Fable 5.1, pontua abaixo do Fable 5. O Sonnet mais novo, Sonnet 5.5, ainda não tem votos suficientes para fechar questão.
Nada disso é o que os nomes sugerem à primeira vista. A orientação atual da Anthropic é começar pelo Opus 5.5 na maioria das cargas de trabalho e subir para o Fable 5.1 quando um raciocínio mais pesado continuar ficando curto. Os casos de uso oficiais são programação agêntica, trabalho de conhecimento e tarefas de longo horizonte. Escrita criativa não está na lista. Ainda assim, os votos de preferência humana colocaram esses modelos no topo.
Nós desenvolvemos o Muses, um espaço de escrita com IA integrada, e acompanhamos os modelos de ponta continuamente porque a qualidade de um rascunho depende de qual modelo está atrás do cursor. Tudo o que está abaixo vem de fontes públicas: o conjunto de dados do ranking da LMArena, o LiveBench e a documentação oficial da Anthropic. Onde os dados acabam — na consistência ao longo de um manuscrito inteiro e em qual modelo recusa menos pedidos —, esta página avisa em vez de inventar resposta.
Resposta curta: qual modelo Claude é melhor para escrever?
| O que você está fazendo | Comece por | Preço / MTok (entrada / saída) | Por quê |
|---|---|---|---|
| Primeiro rascunho de ficção e prosa criativa | Claude Opus 5.5, esforço high | $4 / $20 | Maior estimativa pontual entre os Claude na tabela de escrita criativa com controle de estilo. O intervalo se sobrepõe ao Fable 5 e ao Opus 4.6 em high, e high fica um degrau acima do padrão do Opus 5.5 |
| O mesmo trabalho, se você quiser mais votos sustentando a nota | Claude Fable 5, esforço high | $10 / $50 | 1503 pontos em 8.182 votos, dentro da mesma faixa do Opus 5.5. O Fable 5.1 não ocupa esse lugar |
| Manuscritos longos | Claude Opus 5.5, esforço high | $4 / $20 | Supera o Opus 4.7 em high sem sobreposição de intervalo e custa menos que o preço antigo da linha Opus ($5 / $25). Usa o tokenizador novo, então cabe menos livro na janela do que no Opus 4.6 |
| Revisão seguindo um guia de estilo | Claude Fable 5, ou Opus 4.8 a preço de Opus | $10 / $50, ou $5 / $25 | Seguimento de instruções no LiveBench, esforço max: Fable 5 com 75,8, Fable 5.1 com 73,0, Opus 4.8 com 72,0. O Opus 5.5 em max marca 65,7 |
| Escrita diária com orçamento controlado | Claude Sonnet 4.6 | $3 / $15 | Votos suficientes para ler o resultado com segurança. Fica logo acima do Sonnet 5. O Sonnet 5.5 atual tem 658 votos e ainda não permite cravar posição |
| Texto em grande volume e baixo risco | Claude Haiku 4.5 | $1 / $5 | Cerca de quatro centavos de dólar por sessão de rascunho, 133º lugar na tabela de escrita criativa e o piso de descontinuação mais próximo para ficar de olho |
Se você quiser levar uma única frase: em outubro de 2026, o melhor Claude para um primeiro rascunho é o Opus 5.5 com esforço ajustado para high, o Fable 5 se você preferir confiar numa nota sustentada por milhares de votos a mais, o Opus 4.8 quando a tarefa for revisar pagando preço de Opus, e o Sonnet 4.6 para escrever todos os dias. Teste essa lista curta nas suas próprias páginas. Ela não segue a ordem de lançamento nem a regra de “comprar sempre o mais novo”.
A linha Claude 2026 para quem escreve
A família atual, segundo a visão geral de modelos da Anthropic. Na dúvida, a recomendação oficial da Anthropic é começar pelo Opus 5.5 e recorrer ao Fable 5.1 quando seus próprios testes com esforço mais alto no Opus 5.5 ainda não derem conta.
| Modelo | Contexto | Saída máx. | Preço por MTok (entrada / saída) | Raciocínio (Thinking) | Esforço padrão | Corte de conhecimento confiável |
|---|---|---|---|---|---|---|
| Claude Fable 5.1 | 1M | 128K | $10 / $50 | Adaptativo, sempre ligado | high | jun. 2026 |
| Claude Opus 5.5 | 1M | 128K | $4 / $20 | Adaptativo, sempre ligado | medium | jun. 2026 |
| Claude Sonnet 5.5 | 1M | 128K | $2 / $10 | Adaptativo | high | jun. 2026 |
| Claude Haiku 4.5 | 200K | 64K | $1 / $5 | Estendido | Não suportado | fev. 2025 |
Continuam disponíveis na API, mas listados pela Anthropic como legados: Fable 5, Opus 5, Opus 4.8, 4.7, 4.6 e 4.5, Sonnet 5 e Sonnet 4.6. O Opus 5 e a linha Opus 4.8 até 4.5 custam $5 e $25, acima do Opus 5.5. O Fable 5 tem o mesmo preço do Fable 5.1 ($10 e $50). O Sonnet 5 tem o mesmo preço do Sonnet 5.5 ($2 e $10). O Sonnet 4.6 permanece em $3 e $15 — mais caro que o Sonnet novo, não mais barato. O Sonnet 4.5 é o modelo que está saindo de cena: marcado como obsoleto em 30 de setembro de 2026, ainda aceita chamadas, mas será desligado em 30 de novembro.
Um detalhe importante antes de calcular quanto do seu livro cabe na janela de contexto: a Anthropic mudou o tokenizador a partir do Opus 4.7. No tokenizador atual, 1M de tokens equivale a cerca de 555.000 palavras em inglês; no antigo, o mesmo 1M comportava cerca de 750.000 palavras. A documentação de preços da Anthropic estima um aumento de aproximadamente 30% em tokens para o mesmo texto. Fable 5.1, Opus 5.5, Sonnet 5.5, Fable 5, Opus 5, Sonnet 5, Opus 4.8 e Opus 4.7 usam o tokenizador novo. Sonnet 4.6, Opus 4.6, Sonnet 4.5 e Haiku 4.5 usam o antigo. Uma janela de 1M no Opus 5.5 guarda visivelmente menos capítulos do seu romance do que uma janela de 1M no Opus 4.6, apesar do mesmo número na vitrine.
O que o ranking com controle de estilo mostra na prática
A LMArena coleta votos anônimos de preferência humana em comparações par a par e calcula um rating Bradley-Terry. O controle de estilo (style_control) desconta vícios de formatação que costumam ganhar votos sem representar uma prosa melhor, como respostas longas demais ou cheias de subtítulos e listas com marcadores. Os números abaixo vêm do subconjunto style_control da arena de texto, categoria creative_writing, no conjunto de dados do ranking da LMArena, retrato de 2 de outubro de 2026, arredondados para o inteiro mais próximo.
| Modelo | Variante na arena | Pontuação | Posição | IC 95% | Votos |
|---|---|---|---|---|---|
| Claude Opus 5.5 | claude-opus-5.5-high | 1516 | 2 | 1497–1536 | 1.058 |
| Claude Fable 5 | claude-fable-5-high | 1503 | 3 | 1495–1510 | 8.182 |
| Claude Opus 4.6 | claude-opus-4-6-high | 1501 | 4 | 1494–1507 | 14.085 |
| Claude Opus 4.7 | claude-opus-4-7-high | 1489 | 6 | 1482–1496 | 11.812 |
| Claude Fable 5.1 | claude-fable-5.1-max | 1482 | 10 | 1469–1494 | 2.645 |
| Claude Opus 5 | claude-opus-5-high | 1471 | 13 | 1465–1478 | 13.263 |
| Claude Opus 4.8 | claude-opus-4-8-high | 1470 | 17 | 1463–1476 | 12.798 |
| Claude Sonnet 4.5 | claude-sonnet-4-5-20250929 | 1454 | 33 | 1448–1460 | 12.367 |
| Claude Sonnet 4.6 | claude-sonnet-4-6 | 1449 | 38 | 1443–1456 | 12.339 |
| Claude Sonnet 5.5 | claude-sonnet-5.5-xhigh | 1447 | 42 | 1424–1471 | 658 |
| Claude Sonnet 5 | claude-sonnet-5-high | 1435 | 65 | 1428–1442 | 9.413 |
| Claude Haiku 4.5 | claude-haiku-4-5-20251001 | 1388 | 133 | 1383–1393 | 24.158 |
Os rótulos de esforço na segunda coluna são o que define se você vai rodar de fato a configuração que aparece na tabela.
A linha do Opus 5.5 está em high. Seu padrão na API é medium. Omitir o parâmetro não reproduz essa nota. Fable 5, Opus 4.6, Opus 4.7, Opus 4.8 e Sonnet 5 aparecem em high, que já é o padrão desses modelos. O Fable 5.1 aparece apenas como max, um degrau acima do seu padrão high, ou seja, o Fable 5.1 de fábrica não é a linha da tabela. O Sonnet 5.5 aparece apenas como xhigh, acima do padrão high, com 658 votos. Sonnet 4.6, Sonnet 4.5 e Haiku 4.5 não têm sufixo de esforço no ranking; o Haiku 4.5 sequer aceita esse parâmetro.
O primeiro lugar do Opus 5.5 entre os Claude é uma estimativa pontual, não um isolamento na ponta. O intervalo 1497–1536 se sobrepõe ao Fable 5 (1495–1510) e ao Opus 4.6 em high (1494–1507). Ele de fato supera o Opus 4.7 em high (1482–1496) sem sobreposição, um avanço real sobre o modelo que recomendávamos para prosa longa em agosto. E ele tem companhia fora da família: o Gemini 4 Argon em esforço high marca 1519 (1º lugar, intervalo 1499–1538), sobrepondo-se também ao Opus 5.5.
O Fable 5.1 não herda o posto do Fable 5. A única linha publicada está em esforço max (1469–1494), enquanto o Fable 5 em high fica em 1495–1510. Os intervalos não se tocam. É o oposto do que “mais novo e no esforço máximo” faria supor — com a ressalva de que os ajustes de esforço são diferentes e o high padrão do Fable 5.1 não consta na tabela.
A ordem da linha Sonnet está mais estável do que em agosto, e um integrante está de saída. O Sonnet 4.5 com 1454 (1448–1460) continua acima do Sonnet 5 em high, 1435 (1428–1442), sem sobreposição. Como o Sonnet 4.5 está obsoleto e sai do ar em 30 de novembro de 2026, não vale montar fluxo novo em cima dele. O Sonnet 4.6 com 1449 (1443–1456) também fica acima do Sonnet 5, separados por apenas um ponto nos limites (1443 contra 1442). Já o intervalo do Sonnet 5.5 (1424–1471) cobre Sonnet 4.6, Sonnet 5 e Sonnet 4.5 inteiros; 658 votos não bastam para desempatar.
Entre os modelos que ainda custam $5 e $25, o Opus 4.7 em high (1482–1496) continua superando o Opus 4.8 em high (1463–1476) sem sobreposição — e o mesmo acontece nas linhas sem o sufixo -high, com 1483 (1476–1490) contra 1463 (1457–1470). O Opus 5.5 em high supera o Opus 4.7 em high e custa menos.
Notas de preferência humana são apenas um eixo. O LiveBench (conjunto de questões 2026-06-25, lido em 7 de outubro de 2026) avalia linguagem e seguimento de instruções separadamente, e os dois contam histórias diferentes.
Em linguagem, o Fable 5 em esforço max lidera as linhas Claude com 90,7. O Fable 5.1 em max marca 89,5. O Opus 5 em max faz 88,7. O Opus 5.5 em max fica em 86,3. O Opus mais novo não lidera o quesito linguagem e fica atrás do Opus que substituiu.
Em seguimento de instruções (instruction following), a fila muda toda. O Gemini 3.8 Flash em high lidera a tabela geral com 81,4. O melhor Claude é o Fable 5 em max (75,8), seguido pelo Fable 5.1 em max (73,0) e pelo Opus 4.8 em max (72,0). A maior linha publicada do Opus 5.5 é xhigh com 67,0, e sua linha max marca 65,7. O Opus 4.7 em xhigh faz 66,7; o Opus 5 em max, 63,8. O Sonnet 5.5 vai de 70,5 em xhigh para 56,8 em max, uma oscilação grande que reforça por que não se deve resumir o modelo a um único número.
Não, o líder em escrita não é um modelo feito para escrita criativa
O nome Fable 5 costumava sugerir isso. Agora, ver o Opus 5.5 no topo da tabela de escrita convida a outra suposição: a de que o modelo padrão recomendado pela Anthropic foi calibrado para prosa literária. A documentação diz outra coisa.
A visão geral de modelos orienta começar pelo Claude Opus 5.5 na maioria das tarefas e usar o Claude Fable 5.1 para raciocínio exigente e trabalho agêntico de longo horizonte. A página do Opus 5.5 o descreve como feito para programação agêntica prolongada e trabalho de conhecimento. A página do Fable 5.1 destaca programação agêntica, pesquisa em múltiplas etapas e trabalho com documentos, pelo mesmo preço de entrada e saída do Fable 5. Escrita criativa não aparece em nenhum desses casos de uso.
Posicionamento comercial e desempenho real continuam separados. Em agosto, o modelo no topo do ranking de escrita era o modelo geral mais caro, Fable 5, lançado em 9 de junho de 2026. Em outubro, a maior estimativa pontual pertence ao modelo que a Anthropic já indica como ponto de partida para quase todo mundo, o Opus 5.5, lançado em 22 de setembro de 2026, custando menos que o Fable e menos que o Opus 5. É uma coincidência útil, mas continua sendo coincidência.
Rascunhar, revisar e manter um manuscrito longo são três trabalhos diferentes
Tratar “escrever” como uma habilidade única é a receita para escolher o modelo errado. No mínimo, são três tarefas distintas.
Rascunhar premia o texto que as pessoas gostam de ler, exatamente o que a arena mede. Para gerar prosa nova a partir de uma premissa ou de um esboço, o ranking de escrita criativa aponta para o Opus 5.5 em esforço high, com Fable 5 e Opus 4.6 em high dentro do mesmo intervalo. Se você não ajustar o Opus 5.5 para high, não estará rodando a configuração que conquistou os 1516 pontos.
Revisar exige outra habilidade. Editar significa seguir instruções à risca: manter a voz, cortar 15%, não mexer nos diálogos, aplicar uma folha de estilo. Isso é seguimento de instruções, e o LiveBench embaralha a ordem da prosa. O Fable 5 em esforço max lidera os Claude com 75,8, seguido pelo Fable 5.1 em max (73,0) e pelo Opus 4.8 em max (72,0). O Opus 5.5 fica em 67,0 (xhigh) e 65,7 (max), atrás do Opus 4.8 nas duas linhas publicadas, embora custe menos por token.
Manuscritos longos dependem de janela de contexto e de consistência ao longo das sessões — e é aqui que os dados públicos terminam. A capacidade bruta está documentada: 1M de tokens, cerca de 555.000 palavras em inglês no tokenizador atual (usado por Opus 5.5, Fable 5.1 e Sonnet 5.5). Já a consistência não tem benchmark público. Nenhum teste aberto mede se a voz do modelo desvia ao longo de um projeto de 60.000 palavras, se ele esquece o jeito de falar de um personagem no capítulo 20 ou se começa a achatar sua sintaxe silenciosamente depois da quadragésima revisão. Estamos estruturando testes próprios para medir exatamente isso e publicaremos os resultados aqui quando estiverem prontos.
Quanto custa na prática uma sessão de rascunho de quatro turnos
O cálculo a seguir é uma simulação baseada na tabela oficial de preços da Anthropic, aplicando valores publicados a um formato plausível de sessão para deixar os custos relativos claros.
| Premissa | Valor |
|---|---|
| Gerações por sessão | 4 (um rascunho, três rodadas de revisão) |
| Entrada por geração | ~4.000 tokens (instruções, rascunho atual, notas) |
| Saída por geração | ~1.400 tokens |
| Total da sessão | 16.000 tokens de entrada, 5.600 de saída |
No tokenizador antigo, 1.400 tokens de saída rendem cerca de 1.050 palavras em inglês; no atual, ficam mais perto de 780. Aplicando as tarifas por milhão de tokens:
| Modelo | Palavras produzidas | Custo de entrada | Custo de saída | Custo por sessão |
|---|---|---|---|---|
| Claude Fable 5 e Fable 5.1 | ≈780 | $0,160 | $0,280 | $0,44 |
| Claude Opus 5, 4.8 e 4.7 | ≈780 | $0,080 | $0,140 | $0,22 |
| Claude Opus 5.5 | ≈780 | $0,064 | $0,112 | $0,18 |
| Claude Sonnet 4.6 | ≈1.050 | $0,048 | $0,084 | $0,13 |
| Claude Sonnet 5 e Sonnet 5.5 | ≈780 | $0,032 | $0,056 | $0,09 |
| Claude Haiku 4.5 | ≈1.050 | $0,016 | $0,028 | $0,04 |
A coluna de palavras produzidas não deve ser comparada diretamente entre gerações diferentes de tokenizador: os mesmos 5.600 tokens de saída compram cerca de um terço a mais de palavras no tokenizador antigo (caso do Opus 4.6, do Sonnet 4.6 e do Haiku 4.5).
Dois ajustes mudam esse quadro. O primeiro é o cache de prompt (prompt caching). Leituras de cache custam 10% do preço base de entrada na maioria desses modelos, 5% no Opus 5.5 ($0,20 por milhão de tokens) e 2,5% no Fable 5.1 ($0,25 por milhão de tokens), enquanto o Fable 5 permanece em 10% ($1 por milhão). O trabalho iterativo em um rascunho longo aproveita muito bem esse desconto, desde que o início do prompt fique estático: prompt de sistema, material de referência carregado uma vez e histórico de conversa ao qual você só acrescenta novas mensagens no fim. Se você colar um rascunho reescrito perto do topo do prompt, invalida o prefixo em cache. Já a Batch API da Anthropic dá 50% de desconto na entrada e na saída, mas é assíncrona e não serve para escrita interativa — os valores de $1,50 e $7,50 que às vezes aparecem ao lado do Sonnet 4.6 em tabelas são esse preço de lote, não a tarifa normal de $3 e $15.
O segundo ajuste corre na direção oposta: tokens de raciocínio (thinking tokens) são cobrados como saída. No Fable 5.1 e no Opus 5.5, o raciocínio adaptativo fica sempre ligado e não pode ser desativado, então o parâmetro de esforço é o que controla o quanto você paga por ele.
O ajuste de esforço: a alavanca que quase todo mundo ignora
O guia de esforço da Anthropic traz uma frase que merece atenção: ajustar o esforço costuma ser uma alavanca melhor do que trocar de modelo. O esforço (effort) é um parâmetro da requisição; deixá-lo em branco produz o mesmo comportamento do padrão de cada modelo.
Esse padrão deixou de ser único. O Opus 5.5 vem por padrão em medium. Todos os outros modelos atuais que aceitam o parâmetro vêm em high. O Haiku 4.5 não aceita o ajuste. Fable 5.1, Fable 5, Opus 5.5, Opus 5, Opus 4.8, Opus 4.7, Sonnet 5.5 e Sonnet 5 oferecem cinco níveis, de low a max. Opus 4.6 e Sonnet 4.6 aceitam max e não listam xhigh.
Na escrita, esforço mais alto significa mais planejamento antes da primeira frase: decisões melhores de estrutura, respeito mais consistente a instruções longas e mais atenção aos detalhes pedidos — custando mais e levando mais tempo.
No Opus 5.5, a nota do ranking de escrita criativa corresponde à linha high, um nível acima do padrão medium. Para reproduzir o desempenho da tabela, é preciso subir o parâmetro. Desça para low apenas em reescritas rápidas descartáveis e suba para xhigh no trabalho pesado de estrutura: reorganizar um capítulo, consertar uma seção que sempre desmonta ou cumprir um briefing cheio de restrições.
No Fable 5, Opus 4.7, Opus 4.8 e Sonnet 5, high já é o padrão e corresponde à linha da tabela. Já o Fable 5.1 aparece no ranking apenas em max e o Sonnet 5.5 apenas em xhigh, ambos acima do padrão high.
Recusas, tom e a reclamação de que “o Sonnet ficou mais frio”
Quando escritores reclamam de um modelo, costumam misturar duas coisas diferentes: a recusa direta de um pedido e o cumprimento do pedido num tom seco e sem vida.
Sobre o tom, a queixa da comunidade de que o Sonnet 5 soa mais árido que o Sonnet 4.5 continua sendo relato anedótico, mas encontra eco na tabela de outubro: o Sonnet 5 em high fica 19 pontos abaixo do Sonnet 4.5 (1435 contra 1454), sem sobreposição de intervalos. Como o Sonnet 4.5 se aposenta em 30 de novembro de 2026, voltar para ele tem prazo curto de validade. O Sonnet 4.6, que continua ativo, também fica acima do Sonnet 5 por uma margem estreita.
Sobre as recusas, a documentação oficial ficou mais abrangente do que em agosto. A Anthropic informa que Claude Fable 5.1, Claude Fable 5, Claude Opus 5.5, Claude Opus 5 e Claude Sonnet 5.5 trazem classificadores de segurança que podem recusar uma requisição. Os classificadores do Opus 5.5 cobrem um conjunto mais amplo de categorias do que os do Opus 5. Fora isso, não existe benchmark público medindo taxa de recusa em escrita criativa.
O que resolve na prática é dar enquadramento editorial ao pedido: diga explicitamente que o trabalho é ficção, informe o formato, o gênero e o público leitor, explique o papel dramático daquela cena difícil na trama e peça apenas o grau de detalhe que a cena realmente exige.
Qual Claude escolher para cada perfil de escritor
Orçamento em primeiro lugar. Sonnet 4.6 a $3 e $15 por milhão de tokens. Na tabela de escrita criativa ele fica logo acima do Sonnet 5, que custa $2 e $10. Se a fatura pesar mais que essa vantagem estreita, o Sonnet 5 é a opção medida mais barata. O Sonnet 5.5 custa o mesmo que o Sonnet 5, mas seus 658 votos ainda não dizem se escreve melhor ou pior. O Haiku 4.5 é ainda mais barato e fica na 133ª posição.
Romancistas e não ficção longa. Opus 5.5 com esforço em high para usar a configuração da tabela. Ele supera o Opus 4.7 em high sem sobreposição de intervalo e custa $4 e $20, contra $5 e $25 do Opus 4.7. Lembre-se de descontar o tokenizador novo ao calcular quanto do manuscrito manter em contexto. O Fable 5 é o passo acima se você preferir a nota apoiada em 8.182 votos em vez de 1.058, custando duas vezes e meia o preço por token do Opus 5.5.
Conteúdo diário e rascunhos em alto volume. Sonnet 4.6 como padrão, reservando o Opus 5.5 em high para os textos mais importantes. A cerca de $0,13 por sessão, escrever um texto por dia durante um mês custa trocados perto do tempo economizado. Se tudo o que você quer é uma primeira versão para reagir e editar em cima, descreva a ideia no nosso gerador de texto com IA e ela já abre como rascunho no espaço de trabalho, sem configurar API.
Editores e revisores. Fable 5, pela vantagem em seguimento de instruções no LiveBench: 75,8 em max contra 65,7 (max) e 67,0 (xhigh) do Opus 5.5. Se o orçamento tiver que ficar na faixa do Opus, o Opus 4.8 em max (72,0) continua à frente do Opus 5.5. Se o seu trabalho é aplicar um guia de estilo, segurar a voz do texto e fazer exatamente os cortes pedidos, comece por aí e teste num capítulo que você já conheça de cor.
Boa parte do atrito no dia a dia da escrita não vem do modelo em si: vem de deixar o rascunho numa aba, a pesquisa em outra, o esboço numa terceira e não ter histórico de versões em lugar nenhum. Foi para resolver isso que criamos o Muses: um ambiente de escrita onde rascunho, notas de personagens, referências e revisão assistida por IA moram no mesmo projeto, com histórico para desfazer uma revisão ruim. A própria plataforma seleciona e mantém os modelos atualizados nos bastidores, sem que você precise configurar parâmetros de API por conta própria. Experimente grátis.
Descontinuação de modelos: proteja seu fluxo de escrita
Recomendações de modelos têm prazo de validade. O Sonnet 4.5 foi marcado como obsoleto em 30 de setembro de 2026 e será desligado em 30 de novembro de 2026, com substituição recomendada pelo claude-sonnet-5-5. É o único modelo discutido aqui com data fixa de desligamento.
O Haiku 4.5 segue listado como ativo. A página de descontinuação informa um piso de “não antes de 15 de outubro de 2026”, sem aviso de desligamento publicado até agora (a regra da Anthropic exige ao menos 60 dias de aviso prévio). O piso seguinte entre os modelos mencionados é o do Opus 4.5, não antes de 24 de novembro de 2026.
Os demais têm bastante fôlego: Sonnet 4.6 vai até pelo menos 17 de fevereiro de 2027; Opus 4.6 até 5 de fevereiro de 2027; Opus 4.7 até 16 de abril de 2027; Opus 4.8 até 28 de maio de 2027; Sonnet 5 até 30 de junho de 2027; Fable 5 até 9 de junho de 2027; Opus 5 até 24 de julho de 2027; Fable 5.1 até 1º de setembro de 2027; Opus 5.5 até 22 de setembro de 2027; e Sonnet 5.5 até 28 de setembro de 2027. Todas são datas mínimas garantidas, não anúncios de encerramento.
Se você chama a API diretamente, fixe o ID exato do modelo (claude-opus-5-5, por exemplo). Para entender melhor como combinar diferentes categorias de ferramentas no seu processo, veja também nosso guia sobre como escolher sua ferramenta de IA.
Como mantemos esta página atualizada
Última verificação: 7 de outubro de 2026.
Revisamos esta página mensalmente conferindo três pontos: a linha de modelos e seus IDs, os preços publicados e o retrato mais recente dos rankings. Quando uma pontuação muda o suficiente para alterar uma recomendação, atualizamos o texto e a data no topo da página.
Fontes utilizadas, todas públicas:
- Conjunto de dados do ranking da LMArena — arena de texto, subconjunto
style_control, categoriacreative_writing, retrato de 2026-10-02. Ratings Bradley-Terry baseados em votos anônimos de preferência humana par a par. - LiveBench — conjunto de questões 2026-06-25. Médias das categorias de linguagem e seguimento de instruções lidas em 7 de outubro de 2026.
- Visão geral de modelos da Anthropic — janelas de contexto, limites de saída, preços, modos de raciocínio, esforço padrão, cortes de conhecimento e nota sobre o tokenizador.
- Preços da Anthropic — tarifas por MTok, multiplicadores de cache de prompt e desconto da Batch API.
- Como escolher o modelo certo e Esforço — níveis de esforço e orientação sobre ajustar esforço versus trocar de modelo.
- Recusas e fallback — quais modelos atuais contam com classificadores de segurança.
- Descontinuação de modelos — status do ciclo de vida, datas de desligamento e política de aviso prévio.
Se o seu foco agora for mais o ofício do texto do que a escolha do modelo, nosso guia sobre como melhorar sua escrita detalha o ciclo de rascunho, distanciamento, leitura crítica e revisão em que qualquer um desses modelos se encaixa.
Perguntas frequentes
Qual modelo Claude é melhor para escrever?
O Claude Opus 5.5 com esforço high tem a maior pontuação da família Claude no ranking de escrita criativa com controle de estilo, 1516, mas seu intervalo de confiança de 95 por cento (1497 a 1536) se sobrepõe ao Fable 5 em high (1503, intervalo de 1495 a 1510) e ao Opus 4.6 em high (1501, intervalo de 1494 a 1507). A liderança não está decidida. Além disso, high não é o padrão de fábrica do Opus 5.5, que vem em medium. O Fable 5.1, versão mais nova da linha Fable, marca 1482 em esforço max, abaixo do Fable 5. Já o Sonnet 5.5 ainda tem poucos votos para uma posição firme.
Para textos longos, vale mais o Claude Opus 5.5 ou o Claude Sonnet 5.5?
Pelos números disponíveis hoje, o Opus 5.5. Em esforço high ele marca 1516, com intervalo de 1497 a 1536. O Sonnet 5.5 aparece apenas na linha xhigh, com 1447 e intervalo de 1424 a 1471 com base em 658 votos; os intervalos não se tocam, mas a amostra do Sonnet 5.5 ainda é pequena demais para cravar um ranking definitivo. O Opus 5.5 custa 4 e 20 dólares por milhão de tokens, contra 2 e 10 dólares do Sonnet 5.5. Vale lembrar que high não é o padrão do Opus 5.5 (que usa medium) e xhigh não é o padrão do Sonnet 5.5 (que usa high).
Qual modelo Claude é melhor para escrita criativa e ficção?
O Claude Opus 5.5 em esforço high tem a maior estimativa pontual, 1516. Se você prefere uma nota próxima sustentada por muito mais avaliações, o Fable 5 em esforço high marca 1503 com 8.182 votos, contra 1.058 votos da linha do Opus 5.5, e os dois intervalos se sobrepõem. O Fable 5.1 em esforço max não assume esse posto: fica em 1482, intervalo de 1469 a 1494, abaixo do Fable 5. Evite o Haiku 4.5 para ficção, pois ele ocupa a posição 133 nessa tabela.
O Claude Opus 5.5 ou o Fable 5 foram criados especificamente para escrita criativa?
Não. A Anthropic descreve o Opus 5.5 como o modelo voltado para programação agêntica de longa duração e trabalho de conhecimento, recomendando começar por ele na maioria das tarefas. O Fable 5.1 é voltado para raciocínio pesado e tarefas agênticas de longo horizonte, assim como o Fable 5. Escrita criativa não aparece entre os casos de uso oficiais. As notas de preferência são reais, mas refletem o resultado na prática, não o objetivo original do projeto.
Qual modelo Claude devo usar por padrão para escrever todos os dias?
O Sonnet 4.6, se você quer uma nota de prosa apoiada por votos suficientes. Ele custa 3 e 15 dólares por milhão de tokens e marca 1449, intervalo de 1443 a 1456, logo acima do Sonnet 5 em esforço high (1435, intervalo de 1428 a 1442). O Sonnet 5.5 é o modelo atual e mais barato, a 2 e 10 dólares, mas sua única linha em escrita criativa está em xhigh, com 658 votos e intervalo de 1424 a 1471, cobrindo os dois modelos anteriores.
O Claude consegue escrever um livro inteiro?
Ele consegue guardar um livro inteiro na memória da conversa. Uma janela de contexto de 1M de tokens comporta cerca de 555.000 palavras em inglês no tokenizador atual, então um romance completo cabe numa única sessão. Gerar um bom livro de uma vez só é outro problema, e nenhum modelo resolve isso. O fluxo que funciona na prática é capítulo por capítulo, mantendo o esboço e o guia de estilo no contexto e revisando cada capítulo antes de avançar.
Como mantenho minha própria voz ao escrever com o Claude?
Entregue o seu próprio texto para o modelo trabalhar em cima, em vez de pedir que ele invente prosa imitando seu estilo. Cole dois ou três trechos escritos por você, descreva as regras que segue e peça sugestões de corte e notas de estrutura, não parágrafos prontos. Depois, reescreva a saída com as suas palavras. A voz autoral sobrevive muito melhor à revisão do que à geração pura.
Por que o Claude recusa alguns pedidos de escrita criativa, e qual modelo recusa menos?
A Anthropic documenta classificadores de segurança capazes de recusar pedidos no Claude Fable 5.1, Claude Fable 5, Claude Opus 5.5, Claude Opus 5 e Claude Sonnet 5.5. O comportamento varia entre os modelos, mas não existe benchmark público medindo taxa de recusa em escrita criativa, então qualquer ranking seria chute. O caminho prático é dar contexto: deixe claro que é ficção, informe o gênero e o público-alvo, explique a função dramática daquela cena difícil na história e peça apenas o nível de detalhe necessário.