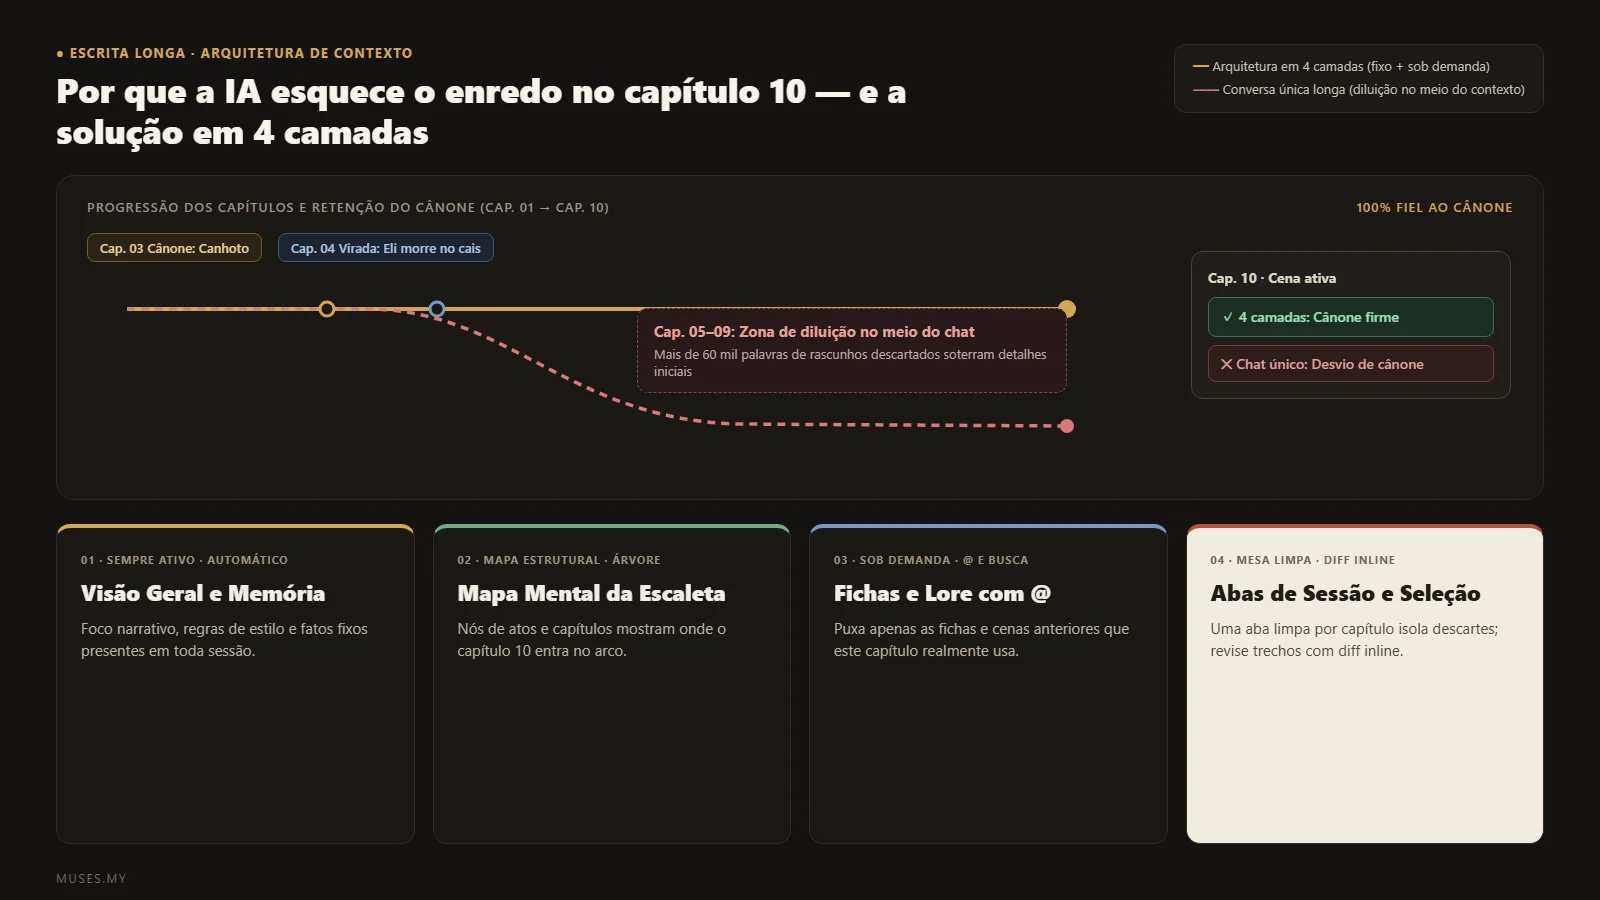
Por que a IA esquece o seu enredo no capítulo 10 (e como gerenciar o contexto em livros longos)
Do capítulo um ao cinco, a IA lembra de cada detalhe. No capítulo dez, seu detetive canhoto usa a mão direita e um personagem morto entra na sala. Veja por que conversas longas perdem o fio da meada — e como uma estrutura em quatro camadas mantém o livro consistente.
Nos cinco primeiros capítulos, a sensação é a de ter encontrado o coautor ideal. A IA lembra que Jonas fala em frases curtas e é canhoto, que chove sem parar há três dias na cidade portuária e que o informante, Eli, morreu no píer no fim do capítulo 4.
Quando você chega ao capítulo 10, a conversa já tem oitenta mensagens. Você pede um rascunho de uma cena tensa na cozinha do apartamento. Segundos depois, o texto aparece: Jonas estende a mão direita para pegar a faca de pão, e Mara sugere ligar para Eli para conferir o manifesto de carga.
Você para e corrige no chat: "Jonas é canhoto, e Eli morreu no capítulo 4." Ela pede desculpas e reescreve a cena. Dois capítulos depois, transforma a irmã de Mara em prima. Frustrado, você fecha aquela conversa lenta e abre um chat novo — só para encarar uma caixa de texto vazia e perceber que agora terá de vasculhar quinze mil palavras de fichas de personagens, notas de construção de mundo e resumos de capítulos apenas para colar contexto suficiente antes de escrever a primeira frase do capítulo 10.
Quase todo mundo que escreve ficção longa ou livros de não ficção no ChatGPT ou no Claude bate nessa parede entre o capítulo 8 e o capítulo 12.
Nota de transparência: Nós desenvolvemos o Muses, um espaço de escrita que coloca o chat de IA dentro do editor. Este texto foi escrito pela equipe, e cada afirmação sobre o produto reflete o que ele faz hoje.
Resumo direto
- Uma janela de contexto maior não garante um livro consistente. O tamanho da janela é um teto de capacidade, não uma garantia de atenção; conforme o chat cresce, os detalhes iniciais soterrados no meio perdem peso.
- Escrever um livro inteiro em um único chat contamina o cânone com rascunhos descartados. Cenas cortadas, rumos de trama rejeitados e três versões do capítulo 7 ficam lado a lado com o seu texto final, e o modelo não sabe qual versão valeu.
- A consistência vem de separar o arquivo da bancada de trabalho. Capítulos prontos, fichas de personagens e a escaleta pertencem ao lado de fora da conversa; o chat deve cuidar apenas da cena que está na sua frente.
- O contexto longo funciona melhor em quatro camadas. Uma base sempre ativa, um mapa estrutural, um arquivo de referência sob demanda e uma bancada limpa para o trecho atual.
- Quando a IA vive dentro do seu projeto, você deixa de trabalhar como entregador de contexto. Ela consegue pesquisar capítulos anteriores, ler materiais e mapas mentais e manter uma memória em camadas sem que você precise colar metade do livro em cada conversa nova.
Por que um chat mais longo faz o modelo esquecer mais
É fácil supor que a IA esquece porque acabaram os tokens. Na prática, mesmo quando um modelo anuncia uma janela de contexto de 200.000 ou 1.000.000 de tokens, os erros de continuidade continuam aparecendo por volta do capítulo 10 se você empilhar tudo em uma única conversa sem fim. Quatro coisas acontecem nos bastidores:
Um: a atenção cai no meio de uma conversa longa. Modelos de linguagem prestam atenção mais nítida ao comecinho do contexto e às mensagens mais recentes. Uma única frase mencionada quarenta turnos atrás — "seu pulso direito nunca cicatrizou direito, então ele usa a mão esquerda" — fica estacionada no vale de baixa atenção no meio do prompt. A menos que algo traga esse detalhe de volta ao foco no turno atual, o modelo recorre ao hábito estatístico da prosa comum: as pessoas pegam objetos com a mão direita.
Dois: rascunhos descartados abafam o que você decidiu manter. Escrever textos longos envolve testar caminhos sem saída. No capítulo 4, talvez você tenha passado cinco mensagens explorando se Eli deveria forjar a própria morte antes de decidir matá-lo de vez. No capítulo 7, talvez tenha testado três finais diferentes. Dentro de um único fio de chat, cada ramificação descartada continua salva no histórico. O modelo não está lendo um manuscrito limpo; está lendo uma sala cheia de anotações contraditórias.
Três: janelas deslizantes e resumos em segundo plano apagam pistas silenciosamente. À medida que a conversa se estica, as ferramentas de chat controlam a latência e o orçamento de tokens cortando mensagens antigas ou resumindo partes iniciais do histórico. Resumos preservam as manchetes do enredo ("Capítulo 4: confronto no píer, Jonas recupera o livro-razão"), mas limpam detalhes físicos ("a página 17 foi arrancada", "o relógio de bolso parou às 3h15"). Quando um detalhe plantado some do resumo, a recompensa narrativa desaparece junto.
Quatro: abrir um novo chat zera o universo da história. Quando uma conversa fica confusa demais para ser confiável, você clica em Novo Chat. Agora o ruído sumiu — e o seu livro também. Você volta a caçar arquivos em pastas e conversas antigas para montar manualmente um dossiê de contexto antes de voltar à frase que queria escrever.
Pare de usar um único chat gigante: a estrutura de contexto em quatro camadas
Manter um livro consistente até o capítulo 30 não exige um chat único que comporte um milhão de palavras. Exige dividir o contexto pela frequência com que ele muda e pelo momento em que a cena realmente precisa dele.
Uma configuração durável para projetos longos separa o contexto em quatro camadas:
| Camada | O que entra aqui | Com que frequência muda | Quando a IA deve ver |
|---|---|---|---|
| 1. Base permanente (Visão geral e regras) | Ponto de vista narrativo, tempo verbal, regras de estilo, premissa central, papel dos protagonistas em uma linha, progresso atual | Raramente; atualizada quando grandes marcos mudam | Injetada no início de cada nova conversa (enxuta: 500 a 1.000 palavras) |
| 2. Mapa estrutural (Escaleta e batidas) | Escaleta capítulo a capítulo, teia de personagens, onde grandes pistas são plantadas e pagas | Atualizada quando a estrutura do enredo muda | Consultada ao planejar um capítulo, checar o ritmo ou verificar causa e efeito |
| 3. Arquivo sob demanda (Personagens, universo e capítulos prontos) | Fichas completas de personagens, cenários, glossário, notas de pesquisa, texto salvo dos capítulos | Cresce continuamente conforme o manuscrito avança | Puxado apenas quando a cena atual toca naquele personagem, lugar ou capítulo anterior |
| 4. Bancada ativa (Cena atual e seleção) | O capítulo aberto na tela, o parágrafo selecionado sob o cursor, o objetivo desta revisão | A cada poucos minutos | Trabalhado em uma conversa limpa e focada, com revisão direto na página |
Essa estrutura resolve a tensão central da escrita longa com IA: o modelo precisa das suas regras globais todas as vezes (Camada 1), precisa de fatos exatos do capítulo 3 quando são relevantes (Camada 3) e precisa de uma bancada silenciosa, livre de cinquenta páginas de conversa irrelevante, na hora de enxugar um parágrafo no capítulo 10 (Camada 4).
Como essas quatro camadas funcionam dentro do Muses
Em uma janela de chat avulsa combinada com o Word ou o Google Docs, você precisa manter essas quatro camadas por conta própria, no braço, usando pastas e copiar e colar. No Muses, o espaço de trabalho já nasce estruturado em torno delas: seu projeto e seus materiais ficam à esquerda, o manuscrito ou mapa mental no centro e o chat de IA à direita.
Camada 1: Memória persistente em níveis (Memória do Usuário, Visão Geral do Projeto e Detalhes do Projeto)
Em vez de despejar o histórico bruto de chat em todo prompt, o Muses estrutura a memória persistente em três partes:
- Memória do Usuário: preferências que acompanham você entre projetos — seu ritmo de prosa preferido, idioma, hábitos de formatação e regras de estilo.
- Visão Geral do Projeto: a base permanente deste livro específico — premissa, foco narrativo, elenco principal, regras do projeto e em que pé está o rascunho.
- Detalhes do Projeto: notas separadas e com título para temas específicos dentro do projeto (como a linha do tempo de uma subtrama ou as regras de uma facção), que também podem ser vinculadas a artigos ou materiais específicos e criadas, ajustadas ou arquivadas conforme o livro evolui.
Quando você inicia uma nova conversa de chat em um projeto, sua Memória do Usuário e a Visão Geral do Projeto são injetadas automaticamente logo no primeiro turno, para que a IA comece com a base do livro sem você precisar colar um preâmbulo. Durante a conversa, a IA pode pesquisar (grep) ou ler e salvar (memory) Detalhes do Projeto sempre que uma cena pedir. O preenchimento automático no editor e o ditado também consultam a Memória do Usuário, a Visão Geral do Projeto e os Detalhes do Projeto ativos vinculados ao documento atual.
Sempre que quiser conferir o que a IA sabe, abra Ver memória no editor para ler sua Memória do Usuário, a Visão Geral do Projeto e os Detalhes do Projeto ativos. Se uma decisão de enredo mudar, avise a IA no chat ou alterne para o modo de trabalho Atualizar memória para que ela revise e reorganize suas memórias com base no projeto.
Camadas 2 e 3: Artigos, materiais e mapas mentais dentro da mesma fronteira de projeto
Os capítulos do seu manuscrito (artigos), os materiais de referência (biblioteca de materiais: artigos de material, arquivos txt / md / docx, PDFs, links da web e imagens) e as escaletas (mapas mentais) vivem todos dentro do mesmo projeto:
- Aponte com
@os arquivos exatos de que uma cena precisa. Ao rascunhar a discussão na cozinha no capítulo 10, digite@na caixa de entrada do chat para anexar Jonas — Ficha de Personagem e Capítulo 4: O Píer (até 5 artigos ou materiais por mensagem) sem sair do editor. - Deixe a IA pesquisar no manuscrito antes de escrever. Se você não lembrar em qual capítulo mencionou a página arrancada do livro-razão ou como se escreve o nome de uma personagem secundária, peça para a IA procurar. A ferramenta
greppesquisa nos artigos salvos do projeto, nos materiais (incluindo artigos de material, arquivos de texto, URLs, resumos de PDF e tópicos de nós de mapas mentais) e nas memórias, e a ferramentareadlê exatamente os blocos ou linhas necessários. - Mantenha a escaleta e a prosa conectadas. A IA consegue ler os mapas mentais do seu projeto como escaletas estruturadas com âncoras de nós. Quando ela propõe alterações em um mapa mental existente, essas edições são marcadas nó por nó na tela para você aceitar ou rejeitar antes que qualquer coisa seja gravada.
Camada 4: Abas multissessão, contexto de seleção e revisão de diferenças no próprio texto
Para evitar que uma única conversa vire um pântano de oitenta mensagens, o Muses inclui um espaço de chat multissessão tanto na web quanto no desktop:
- Abas separadas para tarefas separadas. Abra uma segunda conversa no painel de chat e as abas de sessão, o botão de novo chat e o histórico de sessões aparecem no topo. Você pode manter uma aba aberta para testar a escaleta do segundo ato e abrir uma aba limpa para lapidar os diálogos do capítulo 10 — assim, o brainstorming descartado nunca vaza para a revisão do texto.
- Selecione na página, revise no próprio lugar. Destaque os três parágrafos que você quer enxugar; a seleção acompanha sua mensagem automaticamente. Quando a IA edita um artigo existente, a revisão não sobrescreve o seu rascunho. Ela aparece sobre as frases originais como exclusões e adições na própria linha: se a IA tentar trocar "mão esquerda" por "mão direita", você vê o tachado vermelho na página e clica em Rejeitar naquele item enquanto aceita o resto. Logo após aceitar, você pode desfazer a revisão aceita com um clique (enquanto não tiver continuado a editar o texto). No aplicativo para desktop, projetos locais usam o mesmo fluxo de chat lado a lado, ferramentas de projeto e revisão em linha quando você está conectado e online.
Quatro hábitos que ajudam hoje mesmo — até em uma janela de chat comum
Mesmo que você esteja escrevendo hoje em uma janela padrão do ChatGPT ou do Claude, é possível cortar imediatamente os erros de continuidade do capítulo 10 com quatro hábitos:
Um: nunca trate um histórico de chat como sua fonte da verdade
Uma janela de chat é papel de rascunho; seu manuscrito e seus arquivos de referência são o único cânone. Assim que bater o martelo sobre uma virada de trama ou detalhe de personagem no chat, passe essa decisão para a sua escaleta ou ficha de personagem e atualize o registro antigo. Nunca espere que o modelo adivinhe qual das três opções discutidas trinta mensagens atrás você decidiu manter em segredo.
Dois: escreva um "Cartão de Passagem de Capítulo" de 150 palavras ao terminar cada capítulo
Não cole nove capítulos inteiros no prompt do capítulo 10, nem dependa de um resumo vago de uma linha como "Capítulo 9: Jonas e Mara discutem". Quando terminar um capítulo, gaste dois minutos escrevendo um cartão curto que registre o que mudou no estado físico e narrativo:
[Cartão de Passagem — Capítulo 9]
- Tempo e lugar: Quinta-feira, 23h40, cozinha do apartamento de Jonas no porto velho (a chuva acabou de parar)
- Presentes em cena: Jonas (lesão antiga no pulso direito, sempre usa a mão esquerda; casaco ainda molhado do píer); Mara (em pé perto da janela, de costas para ele)
- Fatos irreversíveis: O informante Eli morreu no píer no cap. 4; a página 17 arrancada do livro-razão está no bolso do casaco de Mara (Jonas ainda não sabe)
- Gancho imediato: Um carro cinza com os faróis apagados acabou de passar lá embaixo; Mara está contando os segundos, esperando Jonas falar primeiro
Em cem palavras, esse cartão trava posições físicas, traços corporais, quem está vivo e quem sabe o quê — exatamente as quatro coisas que um modelo tem mais chance de alucinar.
Três: abra um chat novo para cada capítulo e leve na mala apenas o que entra na cena
Abra uma conversa limpa para cada novo capítulo (ou cada grande cena) e inclua apenas três coisas no seu resumo inicial:
- A base do seu livro em 500 palavras (regras de voz + premissa central);
- Notas de personagem apenas para os personagens que aparecem nesta cena (deixe de fora subtramas e coadjuvantes que não estão na sala);
- O cartão de passagem de 150 palavras do capítulo anterior, mais as três batidas que este capítulo precisa cumprir.
Um prompt enxuto e relevante vence um histórico inchado todas as vezes.
Quatro: quando a IA contradisser o cânone, corrija o prompt em vez de discutir no chat
Quando a IA escreve "Jonas estendeu a mão direita" ou traz um personagem morto de volta à sala, o impulso natural é responder: "Errado! Ele é canhoto, tente de novo!"
Fazer isso uma vez tudo bem. Fazer três vezes enche a conversa com o erro, o pedido de desculpas e o rascunho ruim — mantendo as palavras erradas ativas no contexto recente. Em vez disso, adicione a restrição que faltava diretamente no seu prompt anterior e gere novamente a partir dali, para que a linha do tempo errada nunca permaneça no histórico da conversa.
Conclusão
Quando a IA começa a "esquecer" o seu livro por volta do capítulo 10, o modelo não ficou pior de repente. Um fio de chat linear simplesmente nunca foi projetado para sustentar um livro inteiro. Empilhe construção de mundo, cenas cortadas, escaletas e dez capítulos de prosa em uma única conversa infinita, e qualquer modelo acabará afogado no ruído.
Dividir o contexto em quatro camadas — uma base sempre ativa, um mapa estrutural, um arquivo de referência sob demanda e uma bancada limpa para a cena atual — devolve a espinha dorsal a um projeto longo. O que precisa valer sempre permanece na memória e na visão geral; o que precisa de consulta é puxado dos materiais e capítulos anteriores sob demanda; o que está sendo escrito agora fica em uma sessão focada com revisão em linha.
É assim que o Muses é construído: Memória do Usuário, Visão Geral do Projeto e Detalhes do Projeto mantidos em camadas; artigos, materiais e mapas mentais compartilhando a mesma fronteira de projeto; menções com @ e busca em todo o projeto quando você precisa de capítulos anteriores; abas multissessão para separar o planejamento da escaleta da edição de linha; e revisão de diferenças em linha a cada alteração no texto existente. Para testar no seu próprio manuscrito, inicie um projeto ou explore como o espaço de escrita de romances e o escritor de romances com IA lidam com projetos longos. Se você também cansou de carregar rascunhos entre janelas, continue com O imposto do copiar e colar: quanto realmente custa escrever no ChatGPT e no Claude e Como escrever um livro com IA: um processo em 8 etapas que mantém a sua voz.
Começar é grátis: o plano Gratuito inclui o modelo padrão Clio e 50.000 de StarPower por mês; os planos pagos são cobrados por assinatura, com os preços atuais na página de checkout. Comece grátis.
Perguntas frequentes
Por que a IA esquece detalhes do enredo mesmo com uma janela de contexto enorme?
A janela de contexto mede quanto texto um modelo consegue receber de uma vez, e não o quão uniformemente ele presta atenção ao longo desse texto. Quando um único chat acumula dezenas de rascunhos descartados, desvios e capítulos, os detalhes iniciais enterrados no meio perdem peso para as mensagens recentes ou somem quando a conversa é resumida.
Devo escrever um livro inteiro dentro de um único fio de chat contínuo?
Não. Quanto mais longa fica uma conversa, mais ideias descartadas e versões antigas se acumulam ali dentro, dificultando para o modelo separar o cânone final dos rascunhos rejeitados. Mantenha o cânone fora da conversa e abra chats limpos para cada capítulo ou tarefa.
Preciso colar novamente minhas fichas de personagens e capítulos anteriores toda vez que abro um novo chat?
Em uma janela de chat avulsa, você normalmente precisa montar e colar esse resumo à mão. Quando a IA trabalha dentro do seu projeto de escrita, ela consegue pesquisar e ler diretamente seus capítulos, materiais, mapas mentais e memória persistente, e você pode citar arquivos específicos com @.
Como funciona a memória persistente para projetos longos no Muses?
O Muses organiza a memória persistente em Memória do Usuário entre projetos, uma Visão Geral do Projeto para o livro atual e Detalhes do Projeto separados por tema. Ao iniciar um novo chat, a Memória do Usuário e a Visão Geral do Projeto entram automaticamente, enquanto a IA pesquisa, lê e atualiza os Detalhes do Projeto sob demanda.
Consigo ver o que a IA guardou sobre o meu livro?
Sim. Abra Ver memória no editor para inspecionar sua Memória do Usuário, a Visão Geral do Projeto e os Detalhes do Projeto ativos. Quando algo mudar na história, avise a IA no chat ou alterne para o modo de trabalho Atualizar memória para que ela reorganize suas anotações.
Posso manter chats separados para planejar a escaleta e revisar o texto no mesmo projeto?
Sim. Tanto na web quanto no aplicativo para desktop, o painel de chat oferece suporte a várias abas de sessão dentro do mesmo projeto, permitindo desenvolver a estrutura do enredo em uma aba e lapidar os parágrafos de um capítulo em outra sem misturar contextos.
A busca no projeto, as menções com @ e a memória persistente estão incluídas no plano gratuito?
Sim. O plano Gratuito inclui o modelo padrão Clio e 50.000 de StarPower por mês, com acesso aos artigos do projeto, materiais, mapas mentais, menções com @ e memória persistente; modelos avançados, voz e geração de imagens têm seus próprios limites ou planos.