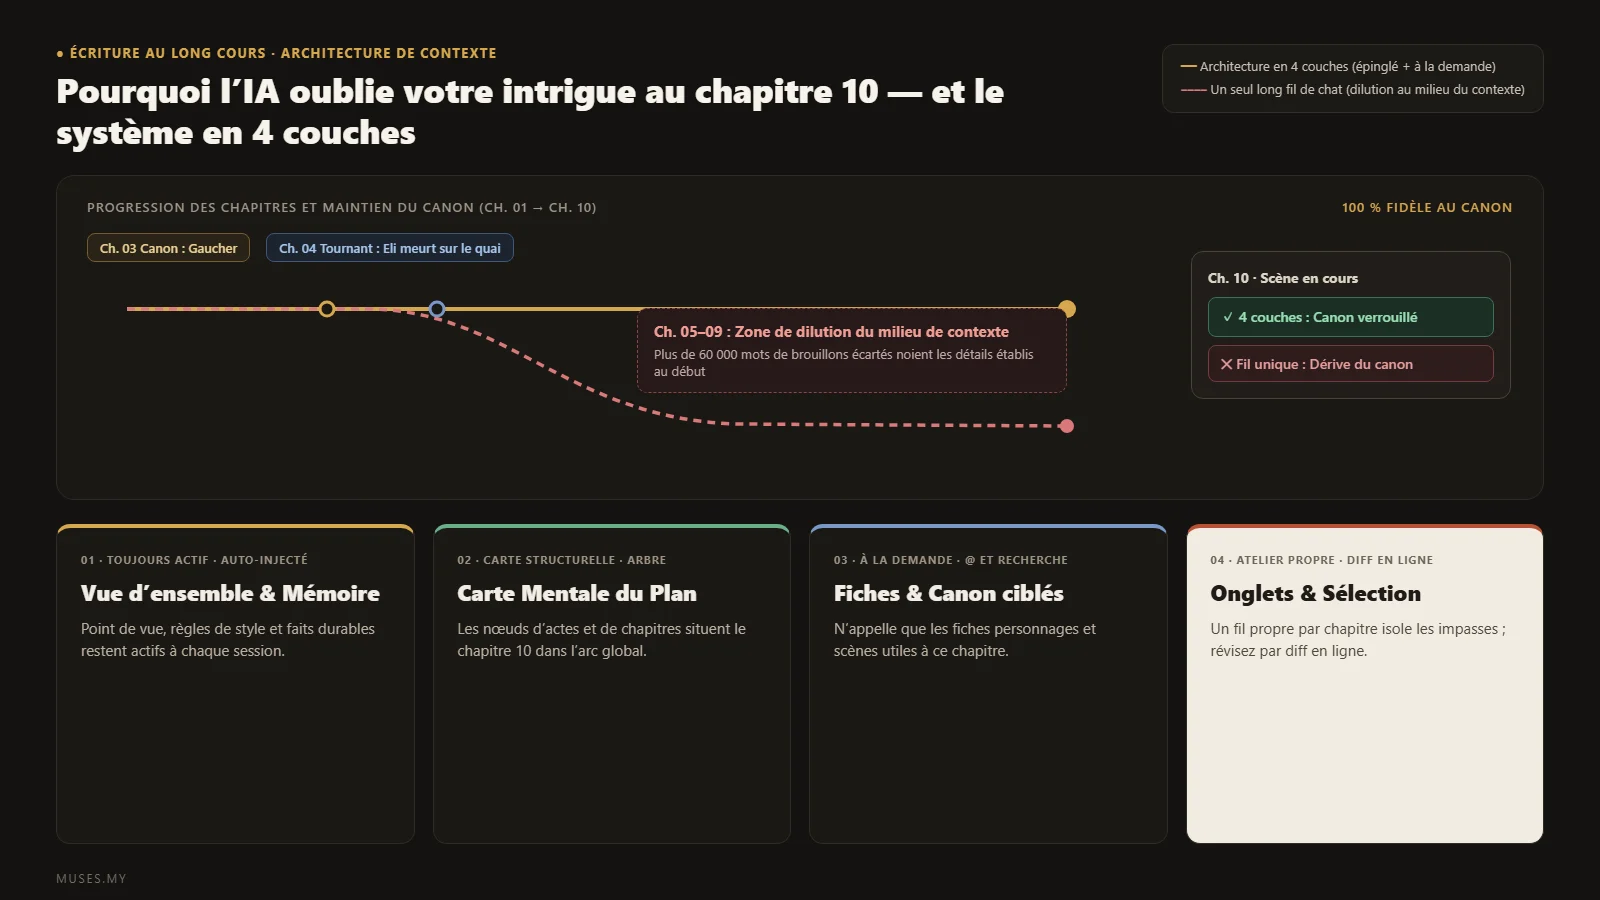
Pourquoi l’IA oublie votre intrigue au chapitre 10 (et comment gérer le contexte sur le long cours)
Des chapitres un à cinq, l’IA retient chaque détail. Au chapitre dix, votre détective gaucher utilise sa main droite et un personnage mort revient dans la pièce. Voici pourquoi les longs fils de discussion perdent le fil — et une structure en quatre couches pour garder un livre cohérent.
Pendant les cinq premiers chapitres, vous avez l’impression d’avoir trouvé le coauteur idéal. L’IA se souvient que Jonas parle par phrases courtes et qu’il est gaucher, qu’il pleut sans discontinuer sur la ville portuaire depuis trois jours et que l’informateur, Eli, est mort sur le quai à la fin du chapitre 4.
Au chapitre 10, le fil compte quatre-vingts messages. Vous lui demandez d’esquisser une scène tendue dans la cuisine de l’appartement. Quelques secondes plus tard, le texte s’affiche : Jonas tend la main droite vers le couteau à pain, et Mara suggère d’appeler Eli pour vérifier le manifeste de cargaison.
Vous vous arrêtez et la corrigez dans le chat : « Jonas est gaucher, et Eli est mort au chapitre 4. » Elle s’excuse et réécrit la scène. Deux chapitres plus loin, elle transforme la sœur de Mara en cousine. Exaspéré, vous fermez ce fil devenu poussif et ouvrez une nouvelle discussion — pour vous retrouver devant une zone de saisie vide, en réalisant qu’il va maintenant falloir fouiller dans quinze mille mots de fiches personnages, de notes d’univers et de résumés de chapitres juste pour coller assez de contexte avant d’écrire la première phrase du chapitre 10.
Presque tous ceux qui écrivent un roman ou un essai au long cours dans ChatGPT ou Claude se heurtent à ce mur entre le chapitre 8 et le chapitre 12.
Note de transparence : Nous développons Muses, un espace d’écriture qui intègre le chat IA directement dans l’éditeur. Cet article est rédigé par l’équipe, et chaque affirmation concernant le produit correspond à son fonctionnement actuel.
En bref
- Une fenêtre de contexte plus grande ne garantit pas un livre cohérent. La taille de la fenêtre est un plafond de capacité, pas une garantie d’attention ; à mesure qu’un fil s’allonge, les détails anciens enfouis au milieu perdent du poids.
- Écrire tout un livre dans un seul fil de discussion pollue votre canon avec des brouillons rejetés. Scènes coupées, pistes abandonnées et trois variantes du chapitre 7 côtoient votre texte définitif, sans que le modèle sache quelle version l’a emporté.
- La cohérence naît de la séparation entre vos archives et votre établi. Les chapitres achevés, les fiches personnages et le plan doivent rester hors de la conversation ; un fil de discussion ne devrait traiter que la scène que vous avez sous les yeux.
- Le contexte au long cours fonctionne mieux en quatre couches. Un socle permanent, une carte structurelle, des archives consultables à la demande et un établi propre pour le passage en cours.
- Quand l’IA vit au cœur de votre projet, vous cessez de jouer les coursiers. Elle peut fouiller dans les chapitres précédents, lire vos matériaux et vos cartes mentales, et entretenir une mémoire de projet structurée sans que vous ayez à recoller la moitié du livre dans chaque nouveau fil.
Pourquoi plus le chat s’allonge, plus le modèle oublie
On suppose volontiers que l’IA oublie parce qu’on a épuisé le quota de tokens. En pratique, même lorsqu’un modèle affiche une fenêtre de contexte de 200 000 ou 1 000 000 de tokens, les erreurs de continuité surgissent invariablement vers le chapitre 10 si l’on empile tout dans une conversation sans fin. Quatre mécanismes l’expliquent :
Un : l’attention s’affaisse au milieu d’un long fil. Les modèles de langue accordent leur attention la plus vive au tout début du contexte et aux échanges les plus récents. Une phrase glissée quarante tours plus tôt — « son poignet droit ne s’est jamais tout à fait remis, si bien qu’il se sert de la main gauche » — se retrouve dans le creux d’attention au milieu du prompt. Si rien ne rappelle ce détail au premier plan lors du tour actuel, le modèle retombe dans l’habitude statistique de la prose ordinaire : les personnages tendent la main droite.
Deux : les brouillons écartés noient ce que vous avez réellement gardé. L’écriture au long cours est pleine d’impasses. Au chapitre 4, vous avez peut-être consacré cinq messages à explorer l’idée qu’Eli simule sa mort avant de décider de le tuer pour de bon. Au chapitre 7, vous avez peut-être essayé trois fins différentes. Dans un fil unique, chaque branche rejetée demeure dans la transcription. Le modèle ne lit pas un manuscrit propre ; il lit une pièce remplie de notes contradictoires.
Trois : les fenêtres glissantes et les résumés en arrière-plan gomment discrètement les indices. Lorsqu’une conversation s’étire, les outils de chat gèrent la latence et le budget de tokens en tronquant les anciens échanges ou en résumant le début du fil. Or un résumé conserve les grands titres de l’intrigue (« Chapitre 4 : confrontation sur le quai, Jonas récupère le grand livre ») mais rabote les détails matériels (« la page 17 est arrachée », « la montre à gousset s’est arrêtée à 3 h 15 »). Dès qu’un indice disparaît du résumé, sa résolution disparaît avec lui.
Quatre : ouvrir un nouveau chat remet le compteur à zéro. Quand un fil devient trop confus pour qu’on s’y fie, on clique sur « Nouveau chat ». Le bruit a disparu — et votre livre aussi. Vous voilà reparti à fouiller vos dossiers et vos anciennes conversations pour assembler à la main un dossier de cadrage avant de pouvoir revenir à la phrase que vous vouliez écrire.
Renoncez au fil unique géant : la structure de contexte en quatre couches
Pour garder un livre cohérent jusqu’au chapitre 30, il ne faut pas un fil de discussion capable d’avaler un million de mots. Il faut répartir le contexte selon sa fréquence de évolution et le moment où la scène en a réellement besoin.
Une organisation durable pour le format long sépare le contexte en quatre couches :
| Couche | Ce qu’on y met | Fréquence de mise à jour | Quand l’IA doit la voir |
|---|---|---|---|
| 1. Socle permanent (Vue d’ensemble et règles) | Point de vue narratif, temps des verbes, règles de style, prémisse centrale, rôle des personnages principaux en une ligne, avancement actuel | Rarement ; mis à jour aux grandes étapes du manuscrit | Injecté au début de chaque nouvelle conversation (format resserré : 500 à 1 000 mots) |
| 2. Carte structurelle (Plan et temps forts) | Plan chapitre par chapitre, réseau de personnages, endroits où les indices majeurs sont semés et résolus | Mis à jour quand la charpente de l’intrigue évolue | Consulté pour préparer un chapitre, vérifier le rythme ou contrôler les liens de cause à effet |
| 3. Archives à la demande (Personnages, univers et chapitres achevés) | Fiches personnages complètes, lieux, glossaire, notes de recherche, texte des chapitres validés | S’enrichit régulièrement au fil de l’écriture | Appelé uniquement lorsque la scène en cours touche à ce personnage, ce lieu ou ce chapitre antérieur |
| 4. Établi actif (Scène en cours et sélection) | Le chapitre ouvert à l’écran, le paragraphe sélectionné sous votre curseur, l’objectif de cette passe | Toutes les quelques minutes | Traité dans un fil propre et ciblé, puis relu directement sur la page |
Cette architecture résout la tension fondamentale de l’écriture longue avec l’IA : le modèle a besoin de vos règles globales à chaque fois (couche 1), de faits précis issus du chapitre 3 lorsqu’ils sont pertinents (couche 3), et d’un établi calme, débarrassé de cinquante pages de bavardage hors sujet, au moment de resserrer un paragraphe du chapitre 10 (couche 4).
Comment ces quatre couches fonctionnent dans Muses
Avec une fenêtre de chat isolée à côté de Word ou de Google Docs, vous devez entretenir ces quatre couches vous-même à coups de dossiers et de copier-coller. Dans Muses, l’espace de travail est bâti autour d’elles : votre projet et vos matériaux se trouvent à gauche, le manuscrit ou la carte mentale au centre, et le chat IA à droite.
Couche 1 : Une mémoire persistante hiérarchisée (Mémoire utilisateur, Vue d’ensemble du projet et Détails du projet)
Au lieu de déverser l’historique brut du chat dans chaque prompt, Muses structure la mémoire persistante en trois volets :
- Mémoire utilisateur : vos préférences transversales d’un projet à l’autre — rythme de phrase, langue, habitudes de mise en forme et règles stylistiques.
- Vue d’ensemble du projet : le socle permanent de ce livre précis — prémisse, perspective narrative, distribution principale, règles du projet et état d’avancement du manuscrit.
- Détails du projet : des notes distinctes et titrées portant sur des sujets précis du projet (chronologie d’une intrigue secondaire, règles d’une faction, etc.), qui peuvent aussi être liées à des articles ou matériaux spécifiques et être créées, corrigées ou archivées à mesure que le livre avance.
Lorsque vous lancez une nouvelle conversation dans un projet, votre Mémoire utilisateur et la Vue d’ensemble du projet sont injectées automatiquement dès le premier tour, de sorte que l’IA démarre avec les fondamentaux du livre sans que vous ayez à coller de préambule. Au fil de l’échange, l’IA peut rechercher (grep) ou lire et enregistrer (memory) des Détails du projet dès qu’une scène l’exige. La complétion en cours de frappe et la dictée dans l’éditeur s’appuient elles aussi sur la Mémoire utilisateur, la Vue d’ensemble du projet et les Détails du projet actifs liés au document ouvert.
Chaque fois que vous souhaitez vérifier ce que l’IA retient, ouvrez la vue de la mémoire dans l’éditeur pour relire votre Mémoire utilisateur, la Vue d’ensemble du projet et les Détails actifs. Si un choix d’intrigue évolue, dites-le simplement à l’IA dans le chat ou passez au mode de travail Mettre à jour la mémoire pour qu’elle passe en revue et réorganise vos notes au regard du projet.
Couches 2 et 3 : Articles, matériaux et cartes mentales réunis dans un même projet
Les chapitres de votre manuscrit (articles), votre documentation (bibliothèque de matériaux : articles de référence, fichiers txt / md / docx, PDF, liens web et images) et vos plans (cartes mentales) cohabitent dans le même périmètre de projet :
- Ciblez avec
@les fichiers exacts dont une scène a besoin. Au moment de rédiger la dispute dans la cuisine au chapitre 10, tapez@dans la zone de saisie du chat pour joindre Jonas — Fiche personnage et Chapitre 4 : Le quai (jusqu’à 5 articles ou matériaux par message) sans quitter l’éditeur. - Laissez l’IA chercher dans le manuscrit avant d’écrire. Si vous ne savez plus dans quel chapitre il était question de la page arrachée du grand livre ou comment s’orthographie le nom d’un personnage secondaire, demandez à l’IA de vérifier. Son outil
grepfouille simultanément dans les articles enregistrés du projet, les matériaux (y compris les articles de matériaux, fichiers texte, URL, résumés de PDF et intitulés de nœuds des cartes mentales) et les mémoires, puis son outilreadlit exactement les blocs ou les lignes nécessaires. - Gardez le plan et la prose reliés. L’IA peut lire les cartes mentales de votre projet comme des plans structurés dotés d’ancres de nœuds. Lorsqu’elle propose des modifications sur une carte mentale existante, ces changements sont signalés nœud par nœud sur le canevas afin que vous puissiez les accepter ou les refuser avant toute écriture.
Couche 4 : Onglets multisessions, contexte de sélection et révision par diff intégré
Pour éviter qu’un fil unique ne tourne au marécage de quatre-vingts messages, Muses propose un espace de chat multisession sur le web comme sur ordinateur :
- Des onglets distincts pour des tâches distinctes. Ouvrez une deuxième conversation dans le panneau de chat : des onglets de session, un bouton de nouveau chat et l’historique des sessions apparaissent en haut. Vous pouvez garder un onglet ouvert pour éprouver la solidité du plan de l’acte II et ouvrir un onglet neuf pour ciseler les dialogues du chapitre 10 — ainsi, les pistes de réflexion écartées ne contaminent jamais vos retouches de style.
- Sélectionnez sur la page, révisez sur place. Surlignez les trois paragraphes que vous voulez resserrer ; la sélection accompagne automatiquement votre message. Lorsque l’IA modifie un article existant, la révision n’écrase pas votre premier jet. Elle s’inscrit directement sur les phrases d’origine sous forme de suppressions et d’ajouts en ligne : si jamais l’IA tente de remplacer « main gauche » par « main droite », vous voyez immédiatement le texte barré en rouge sur la page et cliquez sur Refuser pour cet élément tout en acceptant le reste. Juste après avoir accepté, vous pouvez annuler la révision validée en un clic (tant que vous n’avez pas repris la saisie dans le texte). Sur l’application de bureau, les projets locaux bénéficient exactement du même flux de chat côte à côte, d’outils de projet et de révision en ligne dès lors que vous êtes connecté.
Quatre habitudes utiles dès aujourd’hui — même dans une fenêtre de chat classique
Même si vous écrivez aujourd’hui dans une fenêtre standard de ChatGPT ou de Claude, vous pouvez réduire immédiatement les faux raccords du chapitre 10 grâce à quatre habitudes :
Un : ne traitez jamais un fil de discussion comme votre source de vérité
Une fenêtre de chat n’est qu’un brouillon ; seuls votre manuscrit et vos fichiers de référence font foi. Dès que vous arrêtez un rebondissement ou un détail de personnage dans le chat, reportez-le dans votre plan ou votre fiche personnage et mettez à jour l’ancienne mention. N’attendez jamais du modèle qu’il devine laquelle des trois pistes évoquées trente messages plus tôt vous avez secrètement choisi de retenir.
Deux : rédigez une « fiche de relais de chapitre » de 150 mots à la fin de chaque chapitre
Ne collez pas neuf chapitres entiers dans le prompt du chapitre 10, et ne vous contentez pas non plus d’un résumé vague d’une ligne du type « Chapitre 9 : Jonas et Mara se disputent ». Une fois un chapitre terminé, prenez deux minutes pour dresser une courte fiche qui consigne ce qui a changé dans l’état physique et narratif :
[Fiche de relais — Chapitre 9]
- Temps et lieu : Jeudi, 23 h 40, cuisine de l’appartement de Jonas dans le vieux port (la pluie vient de cesser)
- Présents dans la scène : Jonas (ancienne blessure au poignet droit, utilise toujours la main gauche ; manteau encore trempé du quai) ; Mara (debout près de la fenêtre, lui tournant le dos)
- Faits irréversibles : L’informateur Eli est mort sur le quai au chap. 4 ; la page 17 arrachée du grand livre est dans la poche du manteau de Mara (Jonas l’ignore encore)
- Amorçage immédiat : Une voiture grise tous feux éteints vient de passer en bas ; Mara compte les secondes en attendant que Jonas parle le premier
En une centaine de mots, cette fiche verrouille les positions dans l’espace, les particularités physiques, qui est en vie et qui sait quoi — précisément les quatre points sur lesquels un modèle a le plus tendance à halluciner.
Trois : ouvrez un fil neuf pour chaque chapitre et n’emportez que ce qui entre dans la pièce
Ouvrez une conversation vierge pour chaque nouveau chapitre (ou chaque grande scène) et ne glissez que trois éléments dans votre message d’ouverture :
- Le socle de votre livre en 500 mots (règles de voix + prémisse centrale) ;
- Les notes de personnage uniquement pour les personnages présents dans cette scène (laissez de côté les intrigues secondaires et les figurants absents de la pièce) ;
- La fiche de relais de 150 mots du chapitre précédent, accompagnée des trois temps forts que ce chapitre doit accomplir.
Un prompt sobre et ciblé l’emporte toujours sur une transcription boursouflée.
Quatre : quand l’IA contredit le canon, corrigez le prompt au lieu de débattre dans le fil
Lorsque l’IA écrit « Jonas tendit la main droite » ou fait revenir un mort dans la pièce, le réflexe naturel consiste à répondre : « Faux ! Il est gaucher, recommence ! »
Le faire une fois passe encore. Le faire trois fois remplit le fil avec l’erreur, les excuses et le mauvais brouillon — ce qui maintient les mots fautifs bien actifs dans le contexte récent. Mieux vaut ajouter la contrainte manquante directement dans votre prompt précédent et relancer la génération à partir de là, afin que la mauvaise chronologie ne s’inscrive jamais dans l’historique de la conversation.
L’essentiel à retenir
Quand l’IA commence à « oublier » votre livre aux alentours du chapitre 10, le modèle n’est pas devenu subitement moins performant. Un fil de discussion linéaire n’a tout simplement jamais été conçu pour contenir un livre entier. Empilez univers, scènes coupées, plans et dix chapitres de prose dans un seul déroulé continu, et n’importe quel modèle finira noyé sous le bruit.
Répartir votre contexte en quatre couches — un socle permanent, une carte structurelle, des archives consultables à la demande et un établi propre pour la scène en cours — redonne une colonne vertébrale aux projets au long cours. Ce qui doit rester vrai en permanence demeure dans la mémoire et la vue d’ensemble ; ce qui demande vérification est extrait à la demande des matériaux et des chapitres antérieurs ; ce qui s’écrit à l’instant T reste dans une session ciblée avec révision en ligne.
C’est exactement ainsi que Muses est construit : Mémoire utilisateur, Vue d’ensemble du projet et Détails du projet entretenus par couches ; articles, matériaux et cartes mentales réunis dans un même projet ; mentions @ et recherche à l’échelle du projet lorsque vous avez besoin des chapitres précédents ; onglets multisessions pour séparer le travail du plan et le polissage du texte ; et révision par diff en ligne sur chaque modification apportée à votre prose. Pour l’essayer sur votre propre manuscrit, créez un projet ou découvrez comment l’espace d’écriture de roman et l’assistant d’écriture de roman IA accompagnent les textes au long cours. Et si vous êtes las de transporter vos brouillons d’une fenêtre à l’autre, poursuivez avec La taxe du copier-coller : ce que coûte vraiment l’écriture dans ChatGPT et Claude et Comment écrire un livre avec l’IA : un processus en 8 étapes qui préserve votre voix.
L’inscription est gratuite : l’offre Free inclut le modèle par défaut Clio et 50 000 StarPower par mois ; les formules payantes sont facturées par abonnement, aux tarifs indiqués sur la page de paiement. Commencer gratuitement.
Questions fréquentes
Pourquoi l’IA oublie-t-elle des détails de l’intrigue malgré une immense fenêtre de contexte ?
Une fenêtre de contexte mesure la quantité de texte qu’un modèle peut recevoir en une fois, pas la régularité avec laquelle il prête attention à chaque passage. Lorsqu’un même fil de discussion accumule des dizaines de brouillons rejetés, de digressions et de chapitres, les détails anciens enfouis au milieu perdent du poids face aux messages récents ou disparaissent lorsque la conversation est résumée.
Faut-il écrire tout un livre dans un seul fil de discussion continu ?
Non. Plus un fil s’allonge, plus les pistes écartées et les versions périmées s’y empilent, au point que le modèle peine à distinguer le canon définitif des brouillons abandonnés. Conservez votre canon hors de la conversation et ouvrez des fils propres pour chaque chapitre ou chaque tâche.
Dois-je recoller mes fiches personnages et mes chapitres précédents à chaque nouveau chat ?
Dans une fenêtre de chat isolée, il faut généralement rassembler et coller ce dossier à la main. Lorsque l’IA travaille directement au sein de votre projet d’écriture, elle peut chercher et lire vos chapitres, vos matériaux, vos cartes mentales et votre mémoire persistante, et vous pouvez cibler des fichiers précis avec @.
Comment fonctionne la mémoire persistante pour les projets au long cours dans Muses ?
Muses organise la mémoire persistante en trois volets : la mémoire utilisateur transversale, la vue d’ensemble du projet pour le livre en cours et les détails du projet classés par sujet. À l’ouverture d’un nouveau chat, la mémoire utilisateur et la vue d’ensemble sont injectées automatiquement, tandis que l’IA recherche, lit et met à jour les détails du projet à la demande.
Puis-je vérifier ce que l’IA a retenu de mon livre ?
Oui. Ouvrez le gestionnaire de mémoire dans l’éditeur pour consulter votre mémoire utilisateur, la vue d’ensemble du projet et les détails actifs. Si un élément change, signalez-le à l’IA dans le chat ou passez au mode de travail Mettre à jour la mémoire pour qu’elle réorganise vos notes.
Puis-je garder des conversations séparées pour le plan et les retouches de style dans un même projet ?
Oui. Sur le web comme sur l’application de bureau, le panneau de chat prend en charge plusieurs onglets de session au sein du même projet : vous pouvez travailler la structure dans un onglet et peaufiner un chapitre dans un autre sans mélanger les contextes.
La recherche dans le projet, les mentions @ et la mémoire persistante sont-elles incluses dans l’offre gratuite ?
Oui. L’offre gratuite comprend le modèle par défaut Clio et 50 000 StarPower par mois, avec accès aux articles du projet, aux matériaux, aux cartes mentales, aux mentions @ et à la mémoire persistante ; les modèles avancés, la voix et la génération d’images disposent de leurs propres quotas ou formules.