Por qué la IA olvida tu trama en el capítulo 10 (y cómo gestionar el contexto en textos largos)
Del capítulo uno al cinco, la IA recuerda cada detalle. En el diez, tu detective zurdo usa la mano derecha y un personaje muerto vuelve a entrar en escena. Por qué los chats largos pierden el hilo y cómo mantener la coherencia de un libro con cuatro capas de contexto.
Durante los cinco primeros capítulos sientes que has encontrado al coautor ideal. La IA recuerda que Jonás habla con frases cortas y es zurdo, que lleva tres días lloviendo sobre el puerto y que el confidente, Eli, murió en el muelle al final del capítulo 4.
Cuando llegas al capítulo 10, el hilo acumula ochenta mensajes. Le pides que redacte una escena tensa en la cocina del apartamento. Unos segundos después aparece el texto: Jonás alarga la mano derecha hacia el cuchillo del pan y Mara sugiere llamar a Eli para comprobar el manifiesto de carga.
Te detienes y la corriges en el chat: «Jonás es zurdo y Eli murió en el capítulo 4». Se disculpa y reescribe la escena. Dos capítulos más tarde, convierte a la hermana de Mara en su prima. Frustrado, cierras ese hilo pesado y abres una conversación nueva, solo para quedarte mirando un cuadro de texto vacío y darte cuenta de que ahora tienes que rebuscar entre quince mil palabras de fichas de personajes, notas de mundo y resúmenes de capítulos para pegar suficiente contexto antes de escribir la primera frase del capítulo 10.
Casi todo el mundo que escribe ficción larga o ensayo extenso en ChatGPT o Claude choca contra este muro entre el capítulo 8 y el 12.
Nota de transparencia: Desarrollamos Muses, un espacio de escritura que integra el chat de IA dentro del editor. Este artículo lo escribe el equipo, y cada afirmación sobre el producto corresponde a lo que hace hoy.
En resumen
- Una ventana de contexto más grande no garantiza un libro coherente. El tamaño de la ventana es un techo de capacidad, no una garantía de atención; a medida que el hilo crece, los detalles iniciales enterrados en el medio pierden peso.
- Escribir un libro entero en un solo hilo contamina el canon con borradores descartados. Escenas eliminadas, ramas argumentales desechadas y tres versiones del capítulo 7 conviven con tu prosa definitiva, y el modelo no sabe cuál ganó.
- La continuidad nace de separar el archivo de la mesa de trabajo. Los capítulos terminados, las fichas de personajes y la escaleta deben vivir fuera de la conversación; el chat solo debe ocuparse de la escena que tienes delante.
- El contexto de largo recorrido funciona mejor en cuatro capas. Una base siempre activa, un mapa estructural, un archivo de consulta bajo demanda y una mesa de trabajo limpia para el pasaje actual.
- Cuando la IA vive dentro de tu proyecto, dejas de hacer de mensajero. Puede buscar en capítulos anteriores, leer materiales y mapas mentales, y mantener una memoria por capas sin que tengas que volver a pegar medio libro en cada chat nuevo.
Por qué cuanto más largo es el chat, más olvida el modelo
Es fácil pensar que la IA olvida porque te has quedado sin tokens. En la práctica, incluso cuando un modelo anuncia una ventana de contexto de 200.000 o 1.000.000 de tokens, los fallos de continuidad siguen apareciendo alrededor del capítulo 10 si metes todo en una conversación interminable. Por debajo ocurren cuatro cosas:
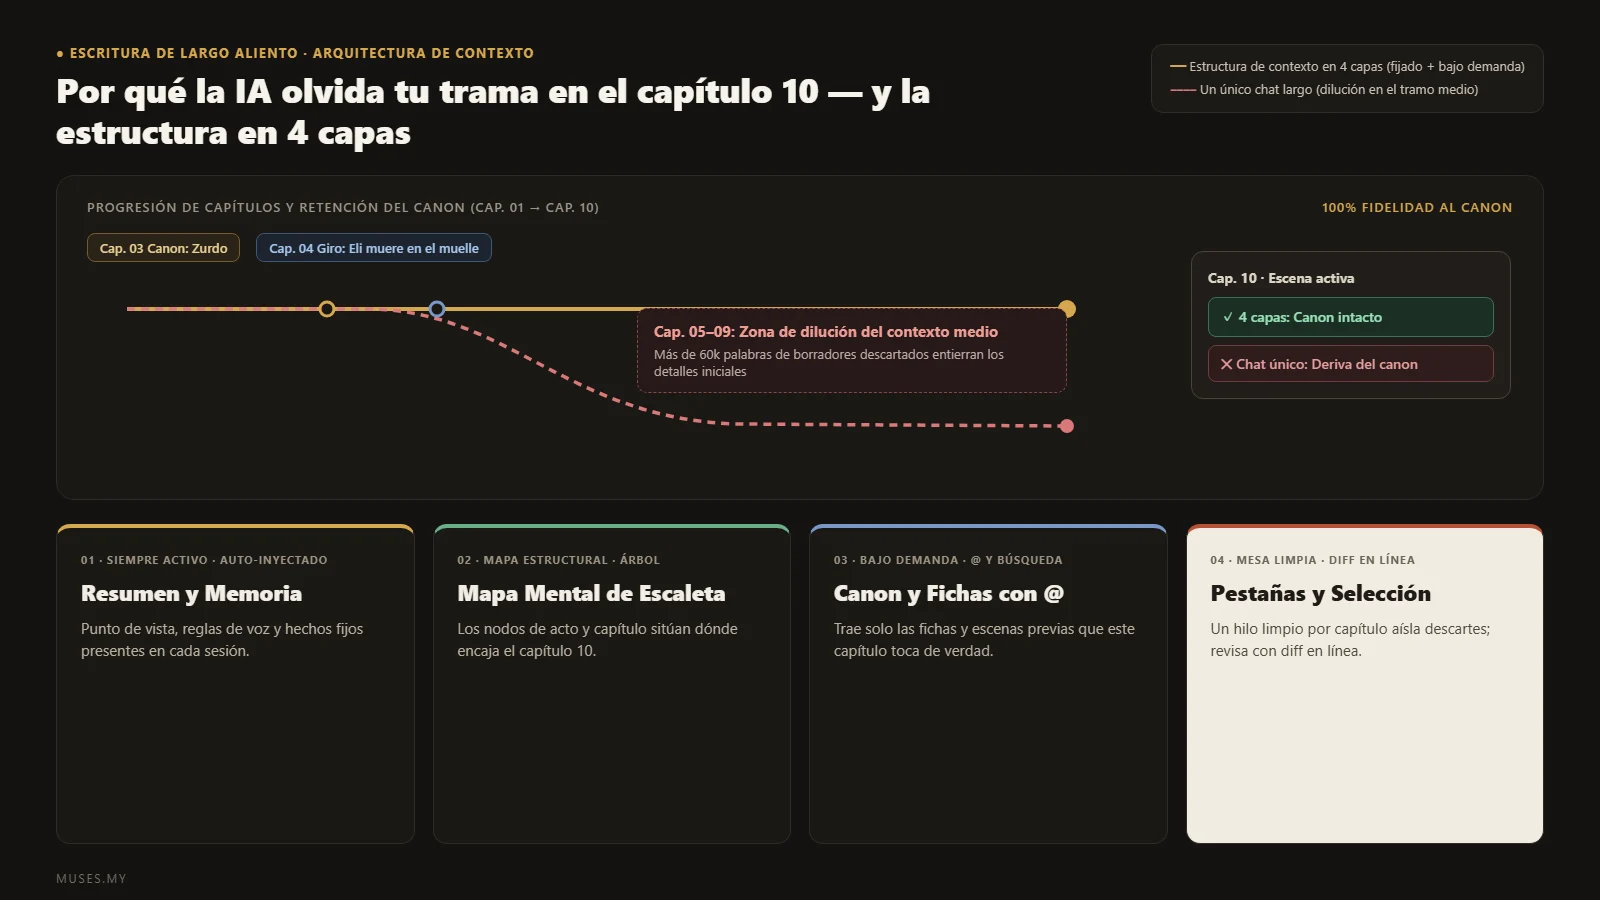
Uno: la atención cae en mitad de un hilo largo. Los modelos de lenguaje prestan mucha más atención al principio mismo del contexto y a los turnos más recientes. Una sola frase mencionada cuarenta mensajes atrás —«su muñeca derecha nunca soldó bien, así que usa la izquierda»— queda sepultada en el valle de baja atención a mitad del historial. A menos que algo vuelva a poner ese dato en primer plano en el turno actual, el modelo recae en la inercia estadística de la prosa corriente: la gente coge las cosas con la mano derecha.
Dos: los borradores descartados ahogan lo que decidiste conservar. Escribir un libro implica probar callejones sin salida. En el capítulo 4 quizá dedicaste cinco mensajes a explorar si Eli debía fingir su muerte antes de decidir matarlo de verdad. En el capítulo 7 tal vez probaste tres finales distintos. Dentro de un único hilo de chat, cada rama descartada sigue en la transcripción. El modelo no está leyendo un manuscrito limpio: está leyendo una sala llena de notas contradictorias.
Tres: las ventanas deslizantes y los resúmenes internos borran pistas en silencio. Cuando una conversación se alarga, las herramientas de chat controlan la latencia y el presupuesto de tokens recortando turnos antiguos o comprimiendo partes previas en resúmenes internos. Un resumen conserva los titulares de la trama («Capítulo 4: enfrentamiento en el muelle, Jonás recupera el libro mayor»), pero elimina los detalles físicos («falta la página 17», «el reloj de bolsillo se paró a las 3:15»). En cuanto una pista desaparece del resumen, su resolución desaparece con ella.
Cuatro: abrir un chat nuevo devuelve el mundo a cero. Cuando un hilo se vuelve demasiado confuso para fiarse de él, pulsas «Nuevo chat». Ahora el ruido ha desaparecido… y tu libro también. Vuelves a rebuscar entre carpetas y conversaciones viejas para armar a mano un dossier de contexto antes de poder retomar la frase que querías escribir.
Deja de usar un hilo gigante: la estructura de contexto en cuatro capas
Para que un libro mantenga la coherencia hasta el capítulo 30 no hace falta un chat donde quepan un millón de palabras. Hace falta dividir el contexto según la frecuencia con que cambia y el momento en que la escena realmente lo necesita.
Una arquitectura sólida para textos largos separa el contexto en cuatro capas:
| Capa | Qué contiene | Con qué frecuencia cambia | Cuándo debe verla la IA |
|---|---|---|---|
| 1. Base permanente (Resumen y reglas) | Punto de vista narrativo, tiempo verbal, reglas de estilo, premisa central, rol de cada protagonista en una línea, progreso actual | Rara vez; se actualiza al cruzar hitos importantes | Se inyecta al inicio de cada conversación nueva (breve: entre 500 y 1.000 palabras) |
| 2. Mapa estructural (Escaleta y escenas) | Escaleta capítulo a capítulo, red de personajes, dónde se siembran y recogen las pistas clave | Cuando cambia la estructura de la trama | Se consulta al planificar un capítulo, revisar el ritmo o comprobar causas y efectos |
| 3. Archivo bajo demanda (Personajes, mundo y capítulos cerrados) | Fichas completas de personajes, escenarios, glosario, notas de documentación, texto de capítulos ya guardados | Crece de forma constante a medida que avanza el manuscrito | Se incorpora solo cuando la escena actual toca ese personaje, lugar o capítulo previo |
| 4. Mesa de trabajo activa (Escena actual y selección) | El capítulo abierto en pantalla, el párrafo seleccionado bajo el cursor, el objetivo de esta pasada | Cada pocos minutos | Se trabaja en un hilo limpio y enfocado, y se revisa directamente sobre la página |
Esta estructura resuelve la tensión central al escribir largo con IA: el modelo necesita tus reglas globales siempre (capa 1), necesita datos exactos del capítulo 3 cuando vienen al caso (capa 3) y necesita una mesa de trabajo despejada, sin cincuenta páginas de charla irrelevante, cuando estás ajustando un párrafo del capítulo 10 (capa 4).
Cómo funcionan esas cuatro capas dentro de Muses
Si trabajas con una ventana de chat suelta junto a Word o Google Docs, tienes que mantener esas cuatro capas a base de carpetas y copiar y pegar. En Muses, el espacio de trabajo está construido sobre ellas: tu proyecto y tus materiales están a la izquierda, el manuscrito o el mapa mental en el centro y el chat de IA a la derecha.
Capa 1: Memoria persistente por niveles (Memoria de usuario, Resumen del proyecto y Detalles del proyecto)
En lugar de volcar el historial bruto de chat en cada mensaje, Muses estructura la memoria persistente en tres partes:
- Memoria de usuario: preferencias que te acompañan entre proyectos, como tu ritmo de prosa preferido, idioma, convenciones de diálogo y reglas estilísticas.
- Resumen del proyecto: la base permanente de este libro concreto: premisa, perspectiva narrativa, reparto principal, reglas del proyecto y punto actual del borrador.
- Detalles del proyecto: notas independientes con título para temas específicos dentro del proyecto (como la cronología de una subtrama o las reglas de una facción), que además pueden vincularse a artículos o materiales concretos y crearse, actualizarse o archivarse a medida que evoluciona el libro.
Cuando abres una conversación nueva dentro de un proyecto, tu Memoria de usuario y el Resumen del proyecto se inyectan automáticamente en el primer turno, de modo que la IA arranca con la base del libro sin que tengas que pegar ningún preámbulo. Durante la conversación, la IA puede buscar (grep) o leer y guardar (memory) Detalles del proyecto cada vez que la escena lo pida. El autocompletado y el dictado dentro del editor también se apoyan en la Memoria de usuario, el Resumen del proyecto y los Detalles del proyecto activos vinculados al documento actual.
Siempre que quieras comprobar qué sabe la IA, abre Ver memoria en el editor para leer tu Memoria de usuario, el Resumen del proyecto y los Detalles activos. Si cambia una decisión de trama, díselo a la IA en el chat o cambia al modo de trabajo Actualizar memoria para que revise y reorganice tus memorias contrastándolas con el proyecto.
Capas 2 y 3: Artículos, materiales y mapas mentales dentro de un mismo proyecto
Los capítulos de tu manuscrito (artículos), el archivo de documentación (biblioteca de materiales: artículos de material, archivos txt / md / docx, PDF, enlaces web e imágenes) y las escaletas (mapas mentales) viven dentro del mismo proyecto:
- Señala con
@los archivos exactos que necesita una escena. Al redactar la discusión en la cocina del capítulo 10, escribe@en el cuadro de chat para adjuntar Jonás — Ficha de personaje y Capítulo 4: El muelle (hasta 5 artículos o materiales por mensaje) sin salir del editor. - Deja que la IA busque en el manuscrito antes de escribir. Si no recuerdas en qué capítulo se mencionó la página arrancada del libro mayor o cómo se escribía el apellido de un personaje secundario, pídele a la IA que lo busque. Su herramienta
greprastrea los artículos guardados del proyecto, los materiales (incluidos artículos de material, archivos de texto, URL, resúmenes de PDF y temas de nodos de mapas mentales) y las memorias, y su herramientareadlee exactamente los bloques o líneas que necesita. - Mantén conectadas la escaleta y la prosa. La IA puede leer los mapas mentales de tu proyecto como esquemas estructurados con anclajes de nodo. Cuando propone cambios sobre un mapa mental existente, esas ediciones se marcan nodo por nodo en el lienzo para que las aceptes o rechaces antes de modificar nada.
Capa 4: Pestañas multisesión, contexto de selección y revisión de diferencias en el texto
Para evitar que un solo hilo se convierta en un pantano de ochenta mensajes, Muses incorpora un espacio de chat multisesión tanto en web como en escritorio:
- Pestañas separadas para tareas separadas. Al abrir una segunda conversación en el panel de chat aparecen en la parte superior las pestañas de sesión, el botón de nuevo chat y el historial de sesiones. Puedes dejar una pestaña abierta para poner a prueba la escaleta del segundo acto y abrir otra limpia para pulir los diálogos del capítulo 10, de modo que las lluvias de ideas descartadas nunca se filtren en tus correcciones de estilo.
- Selecciona en la página y revisa en el sitio. Subraya los tres párrafos que quieres ajustar; la selección viaja automáticamente con tu mensaje. Cuando la IA edita un artículo existente, la revisión no sobrescribe tu borrador: aparece sobre las frases originales mediante eliminaciones y adiciones en línea. Si alguna vez la IA intenta cambiar «mano izquierda» por «mano derecha», verás el tachado en rojo sobre la página y podrás pulsar Rechazar en ese punto mientras aceptas el resto. Justo después de aceptar, puedes deshacer la revisión aceptada con un clic (mientras no hayas seguido editando el texto). En la aplicación de escritorio, los proyectos locales utilizan exactamente el mismo flujo de chat lateral, herramientas de proyecto y revisión en línea al iniciar sesión con conexión.
Cuatro hábitos que ayudan hoy mismo (incluso en una ventana de chat normal)
Aunque hoy escribas en una ventana estándar de ChatGPT o Claude, puedes reducir de inmediato los fallos de continuidad del capítulo 10 con cuatro hábitos:
Uno: nunca trates un hilo de chat como tu fuente de verdad
Una ventana de chat es papel de borrador; tu manuscrito y tus archivos de referencia son el único canon. En cuanto decidas un giro de trama o un rasgo de personaje en el chat, pásalo a tu escaleta o ficha de personaje y actualiza la entrada antigua. Nunca esperes que el modelo deduzca cuál de las tres opciones barajadas hace treinta mensajes decidiste conservar en secreto.
Dos: escribe una «Tarjeta de relevo de capítulo» de 150 palabras al terminar cada capítulo
No pegues nueve capítulos enteros en el prompt del capítulo 10, ni confíes en un resumen vago de una línea como «Capítulo 9: Jonás y Mara discuten». Cuando termines un capítulo, dedica dos minutos a redactar una tarjeta breve que registre qué ha cambiado en el estado físico y narrativo:
[Tarjeta de relevo — Capítulo 9]
- Tiempo y lugar: Jueves, 23:40, cocina del apartamento de Jonás en el puerto viejo (acaba de parar de llover)
- Presentes en escena: Jonás (antigua lesión en la muñeca derecha, usa siempre la mano izquierda; abrigo aún empapado tras volver del muelle); Mara (de pie junto a la ventana, de espaldas a él)
- Hechos irreversibles: El confidente Eli murió en el muelle en el cap. 4; la página 17 arrancada del libro mayor está en el bolsillo del abrigo de Mara (Jonás aún no lo sabe)
- Gancho inmediato: Un coche gris con los faros apagados acaba de pasar por la calle; Mara cuenta los segundos esperando a que Jonás hable primero
En cien palabras, esa tarjeta blinda las posiciones físicas, los rasgos corporales, quién sigue vivo y quién sabe qué: exactamente las cuatro cosas que un modelo tiene más probabilidades de alucinar.
Tres: abre un hilo nuevo por capítulo y mete en la maleta solo lo que entra en la habitación
Abre una conversación limpia para cada capítulo nuevo (o cada escena principal) e incluye únicamente tres elementos en tu mensaje inicial:
- La base de tu libro en 500 palabras (reglas de voz + premisa central);
- Las notas de personaje solo de quienes aparecen en esta escena (deja fuera subtramas y secundarios que no están en la habitación);
- La tarjeta de relevo de 150 palabras del capítulo anterior, más los tres puntos de escaleta que debe cubrir este capítulo.
Un prompt conciso y pertinente supera siempre a una transcripción inflada.
Cuatro: cuando la IA contradiga el canon, corrige el prompt en lugar de discutir en el hilo
Cuando la IA escribe «Jonás alargó la mano derecha» o resucita a un personaje muerto, el impulso natural es responder: «¡Mal! Es zurdo, inténtalo otra vez».
Hacerlo una vez no pasa nada. Hacerlo tres veces llena el hilo con el error, la disculpa y el borrador fallido, manteniendo activas las palabras equivocadas en el contexto reciente. En lugar de eso, añade la restricción que faltaba directamente en tu mensaje anterior y vuelve a generar desde ahí, para que la línea temporal errónea no quede nunca en el historial de la conversación.
En conclusión
Cuando la IA empieza a «olvidar» tu libro alrededor del capítulo 10, no es que el modelo se haya vuelto más torpe de repente. Un hilo de chat lineal simplemente nunca se diseñó para contener un libro entero. Si apilas construcción de mundo, escenas eliminadas, escaletas y diez capítulos de prosa en una sola transcripción infinita, cualquier modelo acabará ahogado en el ruido.
Dividir el contexto en cuatro capas —una base permanente, un mapa estructural, un archivo de consulta bajo demanda y una mesa de trabajo limpia para la escena actual— le devuelve la columna vertebral a un proyecto largo. Lo que debe cumplirse siempre permanece en la memoria y en el resumen; lo que requiere consulta se extrae de los materiales y capítulos previos cuando hace falta; lo que estás escribiendo ahora mismo se trabaja en una sesión enfocada con revisión en línea.
Así está construido Muses: Memoria de usuario, Resumen del proyecto y Detalles del proyecto organizados por capas; artículos, materiales y mapas mentales dentro de un mismo proyecto; menciones con @ y búsqueda en todo el proyecto cuando necesitas capítulos anteriores; pestañas multisesión para separar la escaleta de la corrección de estilo; y revisión de diferencias en línea para cada cambio sobre tu prosa. Para probarlo con tu propio manuscrito, crea un proyecto o descubre cómo el espacio de escritura de novelas y el escritor de novelas con IA gestionan proyectos de largo recorrido. Si también estás cansado de acarrear borradores de una ventana a otra, sigue con El impuesto de copiar y pegar: lo que cuesta de verdad escribir en ChatGPT y Claude y Cómo escribir un libro con IA: un proceso en 8 pasos para mantener tu voz.
Empezar es gratis: el plan gratuito incluye el modelo predeterminado Clio y 50.000 de StarPower al mes; los planes de pago funcionan por suscripción y muestran sus precios actuales en la página de pago. Empieza gratis.
Preguntas frecuentes
¿Por qué la IA olvida detalles de la trama incluso con una ventana de contexto enorme?
La ventana de contexto mide cuánto texto puede aceptar un modelo de una vez, no con qué uniformidad presta atención a todo ese texto. Cuando un solo hilo de chat acumula decenas de borradores descartados, digresiones y capítulos, los detalles iniciales enterrados en la mitad pierden peso frente a los mensajes recientes o desaparecen al resumir la conversación.
¿Debería escribir todo un libro dentro de un único hilo de chat continuo?
No. Cuanto más se alarga una conversación, más ideas descartadas y versiones antiguas se acumulan en ella, lo que impide al modelo distinguir entre el canon definitivo y los borradores desechados. Conviene guardar el canon fuera del chat y abrir conversaciones limpias para cada capítulo o tarea.
¿Tengo que volver a pegar mis fichas de personajes y capítulos anteriores cada vez que abro un chat nuevo?
En una ventana de chat independiente, normalmente tienes que reunir y pegar ese resumen a mano. Cuando la IA trabaja dentro de tu proyecto de escritura, puede buscar y leer directamente tus capítulos, materiales, mapas mentales y memoria persistente, además de permitirte citar archivos concretos con @.
¿Cómo funciona la memoria persistente para proyectos largos en Muses?
Muses organiza la memoria persistente en tres niveles: la memoria de usuario entre proyectos, el resumen del proyecto para el libro actual y los detalles del proyecto por tema. Al iniciar un chat nuevo, la memoria de usuario y el resumen del proyecto se inyectan automáticamente, mientras que la IA busca, lee y actualiza los detalles del proyecto bajo demanda.
¿Puedo ver qué ha recordado la IA sobre mi libro?
Sí. Abre Ver memoria en el editor para revisar tu memoria de usuario, el resumen del proyecto y los detalles activos. Si algo cambia en la historia, díselo a la IA en el chat o cambia al modo de trabajo Actualizar memoria para que reorganice las notas.
¿Puedo mantener chats separados para la escaleta y la corrección dentro del mismo proyecto?
Sí. Tanto en la versión web como en la aplicación de escritorio, el panel de chat admite múltiples pestañas de sesión dentro del mismo proyecto, de modo que puedes trabajar la estructura en una pestaña y pulir el estilo de un capítulo en otra sin mezclar contextos.
¿La búsqueda en el proyecto, las menciones con @ y la memoria persistente están incluidas en el plan gratuito?
Sí. El plan gratuito incluye el modelo predeterminado Clio y 50.000 de StarPower al mes, con acceso a los artículos del proyecto, materiales, mapas mentales, menciones con @ y memoria persistente; los modelos avanzados, la voz y la generación de imágenes tienen sus propios límites o planes.